オブザーバビリティエージェント(Observability Agent)を使用すると、SingleStore ワークスペースの状態について平易な言葉で質問し、独自の監視データに基づいた回答を得ることができます。ユーザーは、稼働中のシステムに対して次のような質問をします。
- このクラスターにおける過去1時間のCPU、メモリ、ディスクの動作状況と、異常値を示すノードがあるかどうかを表示してください。
- 過去30分間で最も多くのリソースを使用したクエリはどれで、それらはどのくらいの頻度で失敗しましたか?
- このパイプラインは、なぜこの2つの期間の間で速度が低下したのでしょうか?
- 今日の午後に発生した障害は、サイズ変更、ノードイベント、またはメモリイベントのいずれかに関連していましたか?
- 今朝の前後で読み書きのスループットを比較して、何が変わったか教えてください。
これらはどれも、やり方さえ知っていれば手作業で答えられるような質問です。エージェントは読み取りを行い、ある信号から次の信号へと証拠を追跡し、原因が明らかになった時点で停止します。その処理過程を表示するため、答えは盲信ではなく検証可能なものとなります。
よくあるデータ監視の問題として、パイプラインの遅延を考えてみましょう。エージェントは、自身の状態、最近の変更、スループット、リソース使用量、エラーなどを確認します。そして、クラスタのイベントや操作が遅延と重なったかどうかをチェックし、応答を読み取る時間内に、考えられる原因と次に調査すべき事項を説明します。
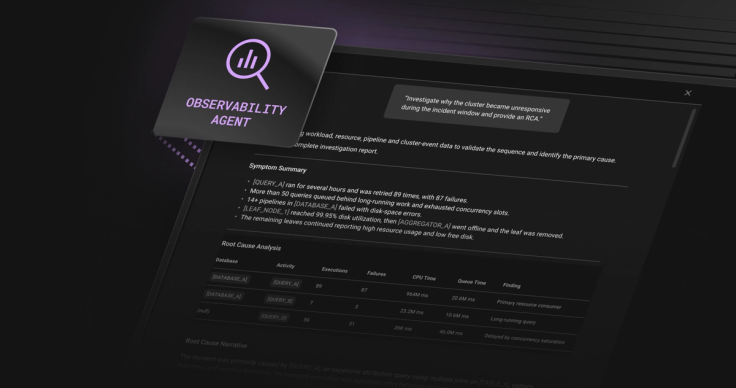
オブザーバビリティエージェントが行うことと行わないこと
エージェントは診断を行うだけで、ユーザーに代わって操作を行うことはありません。データの変更、構成の変更、インフラストラクチャのサイズ変更、ワークロードの停止なども行いません。何が起こっているのかを説明し、対処方法を推奨しますが、最終的な決定はユーザー自身が行う必要があります。
エージェントは、お客様のアクセス権限の範囲内で動作します。すべてのリクエストは、お客様が既に設定しているHeliosのロールベースのアクセス制御の下で実行されるため、エージェントはお客様がアクセスできるワークスペースのみを調査し、お客様が読み取り権限を持つデータのみを読み取ることができます。
これらはどちらも意図的なものです。本番環境のトラブルシューティングを行うエージェントは、何に影響を与えるかを気にせずに実際の問題に対処できる場合にのみ有用であり、その回答が事前に設定した範囲内に収まる場合にのみ信頼できるものとなります。
一見おかしいように見えるチャートから始めて、それをエージェントに渡して何が起こっているのか尋ねることができます。エージェントは、あなたが見ていたものからクラスターと時間ウィンドウを取得し、そこから処理を進めます。
実際のクラスターにおける症状から原因へ
午前中、本番環境のワークスペースでメモリエラーが発生し始めました。エラーメッセージには、到達したメモリ制限値は表示されたものの、その理由についてはほとんど何も書かれていませんでした。
Leaf Error: Memory used by MemSQL (99782.12 Mb) has reached the 'maximum_memory'
setting (99983 Mb) on this node. Possible causes include (1) available query
execution memory has been used up for table memory (in use table memory:
7676.00 Mb) and (2) the query is large and complex and requires more query
execution memory than is available (in use query execution memory 83537.69 Mb).
チームは既に基本的なチェックを済ませていました。そして、それを重大な本番環境インシデントとして報告しました。最初の読み取りは迅速かつ正確でした。メモリはテーブルメモリではなくクエリ実行時に蓄積されていたため、標準的なガイダンスが適用されました。つまり、ワークロードを減らすか、ワークスペースをスケールアップするということです。
正しいのですが、あまり役に立ちませんでした。チームから返ってきたのは、本当に重要な質問でした。コンソールの「クエリ」カテゴリが埋まっていく様子は確認できたものの、その中身は確認できず、「ワークロードを減らす」という指示は、どのワークロードを減らすべきか分からない状況では実行に移せない、というものでした。
原因究明に通常かかること
「どのワークロードか」に手作業で答えるということは、4つの場所から1つの図を組み立てることを意味します。
- メモリ曲線の形状を示すクラスタ詳細ビュー。
- エラーが発生する前に何が実行されていたかを確認するために、履歴ワークロード監視機能を使用する。
- エラー自体については、Loki またはクラスタ レポートによるクラスタ トレース ログを参照する。
- メモリ割り当ての内訳を
SHOW STATUS EXTENDED で確認し、実際にどのカテゴリのメモリが増加しているかを特定する。
次に、最も時間がかかる手順です。それは、過去の同じ時間帯のデータを抽出し、今日と比較しながら手作業で、以前はなかったのに今は存在するワークロードを探すことです。
監視ツールは別々に用意されており、それらの使用手順は、以前にこの調査を行った経験のある人の頭の中にしか存在しません。手順を既に把握していることを前提として、1~3時間を見込みます。今回は、当社のエージェントが実際の顧客インシデント解決に要した時間をお見せします。
オブザーバビリティエージェントが行ったこと
顧客が報告したエラーと発生時期をエージェントに伝え、処理を任せたところ、証拠の順序通りに処理されました。
エージェントはまずテーブルメモリを除外しました。テーブルメモリは、エラーメッセージ自体が報告している約7.7GBで、ウィンドウ全体を通してほぼ一定でした。クエリ実行メモリは、わずか5分間の間に約2.4GBから70GB以上に急増しました。これは緩やかな増加ではなく急激な変化であり、テーブルメモリがメモリ消費の原因ではないことを示唆し、調査対象は保存されたデータではなく、実行中のプロセスにあることを示唆しています。
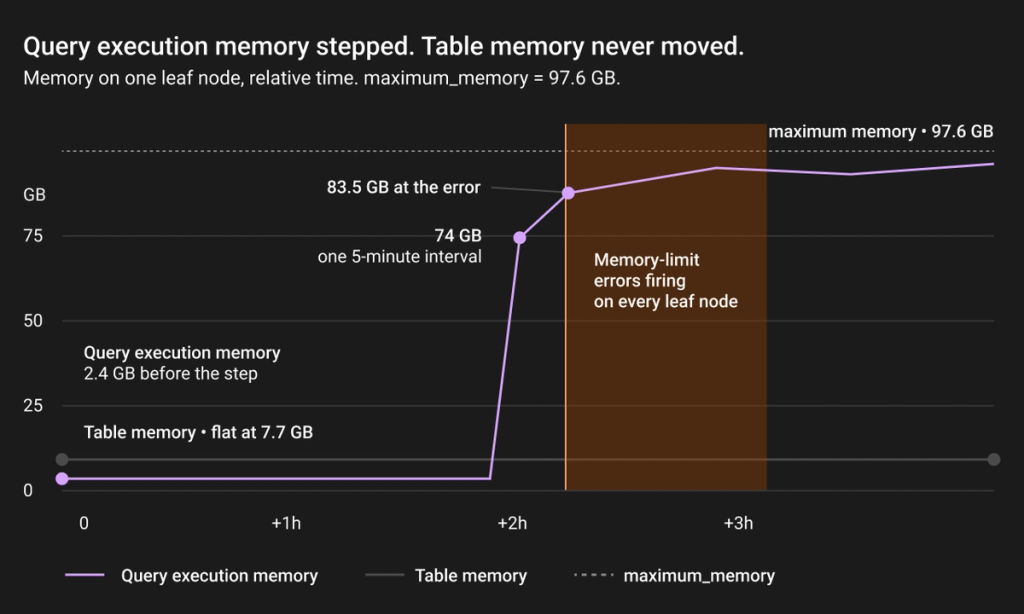
Aggregated Memory usage chart
次に、エージェントはワークロードの実行時間ではなくメモリ使用量に基づいてランク付けを行いました。
これが、チーム自身による調査が成果を上げられなかった理由です。彼らは長時間実行されるクエリを探していたのですが、複数の試行が同時に実行された結果、上限に達してしまっていたのです。探すべき単一のクエリは存在しませんでした。
Activity | Database | Memory (GB-samples) | Executions | Failures | Spill (GB) |
SelectReport_A_v1 | reporting | 1,000,722 | 130 | 104 (80%) | 0 |
SelectReport_A_v2 | reporting | 811,085 | 61 | 51 (84%) | 0 |
RunPipeline_B | reporting | 17,141 | 72 | 72 (100%) | 0 |
SelectReport_A_v3 | reporting | 13,853 | 4 | 4 (100%) | 2.06 |
InsertSelect_B | reporting_migration | 13,176 | 3 | 0 | 0 |
SelectReport_C | reporting | 1,788 | 9 | 9 (100%) | 40.11 |
GB-samplesはモニタリングサンプル全体でメモリを合計した値なので、この列はピークサイズではなく持続的なメモリ負荷を示しています。シェアとして見ると、状況は一目瞭然です。上位2行でこれら6つのワークロード全体のメモリ使用量の97.5%を占めており、3番目にランクインしたワークロードは1番目にランクインしたワークロードの2%未満です。また、これらは同じレポートクエリの2つのバリエーションでもあります。
失敗率が実際の結果を明らかにしました。どちらも80~84%の確率で失敗していました。
エージェントは、障害の原因をメモリ負荷と関連付けました。メモリ割り当ての大部分を占め、5回中4回失敗するワークロードは、再試行中のワークロードであり、各試行は再びメモリを消費してから再び失敗します。クエリの失敗を引き起こした状況は、クエリ自体によって維持されていました。最終的に、すべてのリーフノードでメモリ制限エラーが発生し、約1時間継続しました。
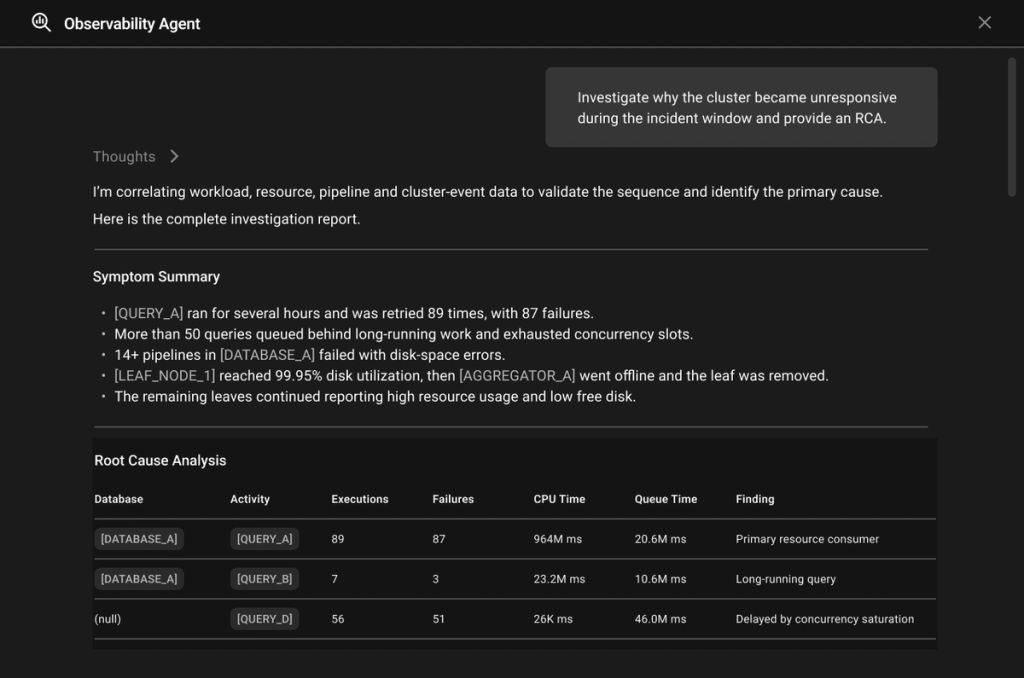
Example of Agent Response
なぜ2番目の回答は1番目の回答と異なったのか
最初の回答は「ワークロードを減らすか、スケールアップする」というものでした。2番目の回答では、変更すべきオプションとして、SelectReport_A バリアントを生成する Looker レポートを見つけてスロットリングするという方法が示されました。ワークロードが 80% の確率で失敗し、再試行を繰り返すことで、問題がサイクルごとに悪化しているからです。スケールアップは選択肢として残りましたが、もはや唯一の手段ではなく、それだけでは単に再試行ループに余裕を与えるだけだったかもしれません。
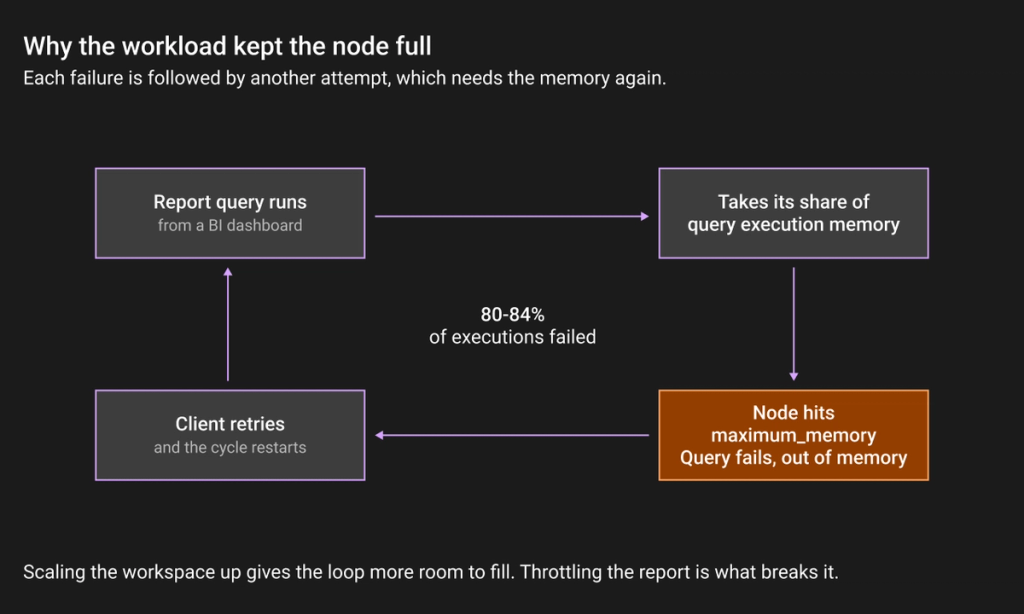
Memory exhaustion pattern
エージェントは新たな問題も検出しました。SelectReport_Cがメモリ制限に達した際に40GB以上のデータをディスクに書き込んでおり、これは最初の問題が解決された後もトラブルを引き起こし続ける可能性のある、2つ目の負荷要因でした。
担当者は、根拠に基づいた順位付けされた説明をダッシュボードを添えて作成し、それに基づいて行動できる担当者に、具体的で検証可能な調査結果を手渡しました。
顧客は分析結果を認め、指摘された疑問点について調査すると述べたため、チケットはクローズされました。
エージェントがその結論に達するまでの時間:貼り付けられたエラーから、対処すべき発見事項のランキングリストが表示されるまで、約2分。
SingleStoreで構築した理由
SingleStore は、クラスタの状態、ワークロード履歴、Helios のパイプラインアクティビティなど、これらの調査の背後にあるデータ可観測性シグナルを既に保持しています。調査の各ステップでは、異なる質問がされます。「テーブルメモリは増加しているか」では、1 つのメトリックを時系列で読み取ります。「どのワークロードがメモリを消費しているか」では、5 時間分のクエリ履歴をその中のすべての異なるクエリごとにグループ化し、結果をランク付けします。「その 2 つの失敗はどのくらいの頻度で発生したか」では、同じ履歴に戻り、別の方法でスライスします。各質問は前の回答が得られた後にのみ存在するため、このシーケンスを計画するのは困難です。事前計算されたロールアップはここでは役に立ちません。ロールアップは、誰かが事前に考えた質問に答えるものであり、ダッシュボードも同様です。調査とは、最後の回答によって次に尋ねざるを得なくなるものです。これが、2 分で調査が完了できる理由です。証拠を追跡するエージェントは、時として間違ったリードを追跡することがありますが、間違ったリードによって別のクエリのコストがかかる場合のみ、そのようなことを許容できます。Singlestore は、これを数分で実行できる市場で数少ないデータベースの 1 つです。
エージェントはどこを探せばいいのかどうやって知るのか
エージェントは、そのインシデントをその場しのぎで解決したわけではありません。まずテーブルメモリを除外します。ワークロードを期間ではなくメモリ使用量でランク付けします。最も負荷の高いワークロードの障害発生率を確認します。これは、メモリ負荷に関するチケットで当社のエンジニアが使用する手順であり、症状が一致した際にエージェントが参照するプレイブックとして文書化されています。
調査はめったに一直線に進むものではありません。今回の調査は、チームが最初の回答に異議を唱えたことで方向転換しましたが、これは例外ではなくむしろ通常のケースです。調査者は既に収集した証拠を保持するため、異議申し立ては調査をやり直すのではなく、むしろ調査範囲を絞り込むことになります。
その結果、再現性が得られます。異なる集団に属する異なる人物の同じ症状に対しても、同じ方法で対処できます。
オブザーバビリティエージェントを試す方法
ポータルやオブザーバビリティダッシュボードからアクセスできます。ダッシュボードでは、パネルとその時間枠を直接会話に送信し、エージェントに説明を求めることができます。最適な結果を得るには、具体的な質問を投げかけてください。クラスターまたはワークスペース、関心のある時間枠、そして実際に観測した内容を伝えてください。
最初のリリースは、目の前の問題に対して、当社の監視スタックのエキスパートになることなく解決策を求めているユーザー向けです。次にリリース予定のサポートエージェントにご注目ください。このエージェントは、これらの監視結果に基づいてお客様が適切な対応を取るお手伝いをします。また、これらのエージェントを、当社のリモートMCPサーバーを介してMCPクライアントから安全に利用できるようにするための取り組みも進めています。現在、一部のお客様を対象に展開中です。お試しになりたい場合は、サポートチームまたは製品チームまでお問い合わせください。調査にかかる労力を軽減できます。