クエリの実行速度が遅い場合、データの配置やシステム内での移動方法によっては、いくつかの解決策が考えられます。SingleStoreの分散実行エンジンは、次のような選択肢を提供します。シャードキーはデータの保存場所を決定し、ネットワークシャッフルを回避するコロケーション結合を可能にします。ソートキーはカラムストアテーブルのセグメント削除を促進し、プロジェクションは代替アクセスパスを提供します。これらのどれをいつ変更すべきかを判断するには、データベースに関する深い知識が必要です。
クエリ最適化に関する専門知識は、それ自体では拡張性に乏しい。その多くは、何百ものワークロードをチューニングしてきたソリューションエンジニアやサポートエンジニアといった専門家の頭の中に蓄積されています。開発者が遅いクエリに遭遇した場合、解決策を見つける最速の方法は、ツールではなく、多くの場合、人に相談することです。
このワークフローでは、複数のコンテキスト切り替えが必要です。まず、データベースにデバッグプロファイルを生成します。次に、コマンドラインスクリプトでそれをクリーンアップします。そして、それを大規模なナレッジベースファイルとともにチャットツールにアップロードします。最後に、その回答をSQLに変換して適用します。切り替えのたびに、作業が煩雑になります。
遅いクエリから優先順位付けされたチューニング推奨事項まで
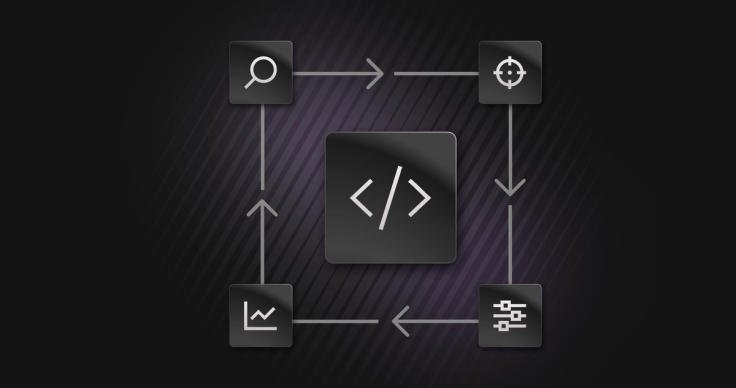
パフォーマンスチューニングエージェントは、断片化されたワークフローを単一のガイド付きループに置き換えます。まず、低速なSQLクエリまたはデバッグプロファイルから始めます。エージェントはプロファイルとスキーマを検査し、優先順位付けされた検出結果と裏付けとなる証拠を返します。検証済みのSQLを非本番環境にコピーして適用し、再度プロファイルを作成して比較します。
AIエージェントは、パフォーマンスエンジニアが使用するのと同じ信頼できる情報源、つまりSingleStoreのデバッグプロファイルに基づいて動作します。デフォルトのプロファイルには、本格的なチューニングに必要な詳細情報が含まれていないため、エージェントはワークスペースとデータベースのコンテキストが揃った時点で、必要に応じてデバッグプロファイルを取得します。また、デバッグプロファイルのJSONファイルをアップロードすることもできるため、ライブ接続なしでセルフホスト型システムのプロファイルを分析できます。
レコメンデーションはSingleStore固有のものです。エージェントは、分散エンジン上で最も重要なパターンを検出し、説明するように設計されています。
- ブロードキャストとリパーティションを多用する結合
- パーティション間およびスレッド間でのデータ偏り
- シャードキーの選択により、共存結合やローカルグループ化がブロックされる
- ソートキーの不一致と弱いセグメント除去
- カーディナリティ推定の誤りと古い統計情報
- スピルとハッシュビルドの配置
- コンパイル時のオーバーヘッドとプランキャッシュの欠落
- プロジェクション、ハッシュインデックス、および参照テーブルのトレードオフ
エージェントのクエリ最適化に関する推奨事項は、一般的なデータベースのアドバイスではなく、オペレーターのタイミング、セグメントのスキャンとスキップ、スキュー比率、推定行数と実際の行数の比較に基づいて作成されます。
クエリチューニングエージェントがボトルネックを見つける方法
内部的には、AIエージェントは自由形式のチャットではなく、定義されたパイプラインを実行します。その手順は決定論的で、観測可能です。
- ライブキャプチャまたはアップロードされたJSONファイルから、クエリとそのデバッグプロファイルを取り込みます。
- プロファイルをクリーンアップして正規化することで、モデルは重要なフィールドのみを認識し、ノイズは認識しなくなります。
- 実行計画を解析し、演算子ごとのタイミングを抽出し、分散操作を特定する。
- ボトルネックを検出し、根本原因を分類する。
- 厳選されたチューニング知識ベースから、関連するパターンとトレードオフを検索する。
- 解決策を提案し、その根拠となる理由を説明付きで提示する。
- 生成されたDDLは、表示する前に必ず検証する。
フローが明示されているため、セッションがそのフローに従ったかどうか、ツール呼び出しの回数、および出力が取得された知識に忠実であったかどうかを測定できます。
典型的な推奨事項の仕組みは次のとおりです。開発者が2つの大きなテーブル間で結合処理を実行したところ、処理速度が遅いことがわかりました。エージェントはプロファイルを読み取り、ブロードキャスト結合を検出し、その原因がシャードキーの不一致にあることを突き止めます。
Bottleneck: Broadcast join detected.
Tables `orders` and `customers` are not sharded on the join column, so `customers` is broadcast to every partition.
Fix: Align both tables on the join column to enable a collocated join.
-- Candidate DDL (validate in non-production first)
CREATE TABLE orders_v2 (
 ...
  SHARD KEY (customer_id)
);
エージェントはトレードオフを分かりやすい言葉で説明します。
Visual Explain、SQL Editor、およびクエリ履歴におけるクエリチューニング
エージェントは、既にチューニング作業が行われている場所に現れます。
Entrypoints for Query Tuning Agent
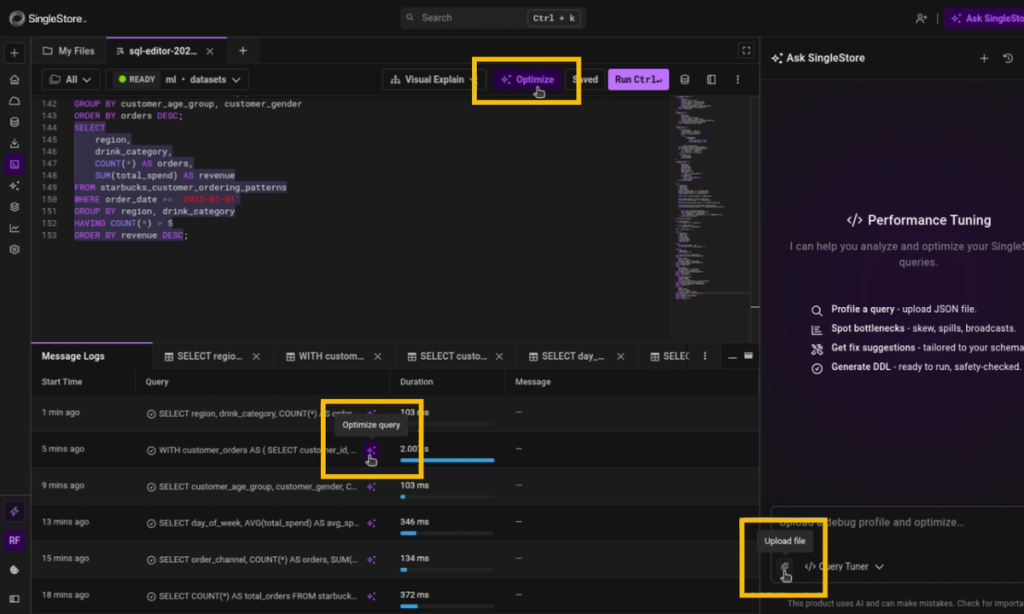
ポータルでは、サイドバーアシスタントとして動作します。Visual Explainから最適化アクションを実行すると、クエリを含むエージェントが起動し、バックグラウンドで生のプロファイルが添付されるため、手動で何もコピーすることなく、ビジュアルプランからガイド付き修正へと移行できます。また、デバッグプロファイルJSONをサイドバーに直接アップロードすることもできます。これは、サポートチームやソリューションチームが、セルフホスト型デプロイメントの顧客プロファイルを分析する際に使用する方法です。
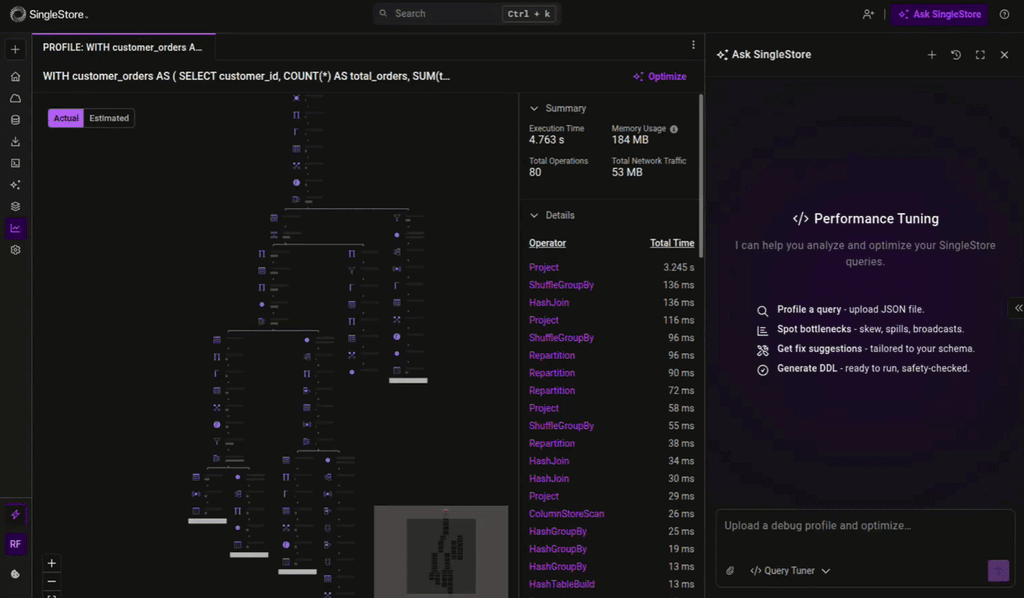
Query Tuning from Visual Explain
SQL エディターで作業している場合でも、最適化アクションを使用できます。クエリを選択し、[最適化] をクリックすると、エディターがクエリのプロファイルを作成し、サイドバーでクエリ チューナーを実行します。この場合も、SQL やファイルを手動でコピーする必要はありません。対象のクエリが既に履歴にある場合は、そこから開始することもできます。過去の実行に対して [最適化] をクリックすることで、以前に処理が遅かったクエリに戻り、履歴リストから直接チューニングを開始できます。
ポータル以外では、チューニングロジックをMCPサーバーのスキルとして提供する予定です。MCPクライアントをお持ちの開発者であれば、誰でもこのスキルを呼び出し、自身のプロファイルに対して実行し、フィードバックをお送りいただけます。お客様やコミュニティの皆様に、このスキルをオープンな環境でテストしていただき、まだ対応できていないケースを見つけるお手伝いをしていただきたいと考えています。
当社のクエリ最適化が設計段階から安全である理由
チューニングに関するアドバイスは、信頼できる場合にのみ役立つため、エージェントはデフォルトでは保守的な設定になっています。
エージェントは説明のみを行い、実行は行いません。適切なコンテキストがある場合には読み取り専用のプロファイリングを実行する可能性がありますが、DDLとDMLはテキストとして返されるため、ユーザーは確認して適用することができます。
生成されたステートメントは、構文と意味的な制約(例えば、シャードキーが主キーのサブセットである必要があるなど)についてチェックされます。フィードバックループによってシステムが閉じられます。すべての推奨事項には、賛成か反対かの評価と、オプションのコメントが付与されます。特にソリューションエンジニアやサポートエンジニアからの否定的なフィードバックは、レビュー項目となり、敵対的サンプルとして評価スイートに反映されます。
内部評価スイートは、既知のボトルネックを含む合成タスク、専門家の回答に基づいて評価される匿名化された実世界のプロファイル、およびエッジケースや敵対的入力を含む回帰テストセットを組み合わせて構成されています。データベースの削除要求などの敵対的入力は拒否する必要があります。このスイートはエージェントの進化に合わせて実行されるため、ある領域の改善が別の領域を密かに悪化させることはありません。
パフォーマンスチューニングエージェントにより、専門家レベルの診断とクエリ最適化を再現可能かつ早期に利用できるようになります。サポートチームとソリューションチームは、チューニング調査の初回チェックを一貫して行えるため、より困難なケースに時間を割くことができます。お客様は、SingleStoreのチューニングに関する知識を、より身近な場所で活用できます。これにより、判断の規模を拡大できます。ただし、これらの機能は、非常に複雑で未知のシナリオにおける専門家の判断に取って代わるものではありません。
お客様のデータは決して変更されません
クエリ チューニングは、推定値ではなく実際の実行プロファイルに基づいて動作するため、ワークスペースに対してクエリを実行し、実際の行数と実行時間を取得します。プロファイリングでは、UPDATE、DELETE、INSERT ... SELECT といった書き込みなどのステートメントも実行されるため、プロファイルされたすべてのクエリは明示的なトランザクションでラップされ、常にロールバックされます。クエリ チューニングがユーザーに代わって実行する処理は、決してコミットされません。
ロールバックはベストエフォートではなく保証されています。プロファイル対象のクエリが途中で失敗した場合でもロールバックが実行されるため、失敗したステートメントや不正なステートメントによってセッション上に未完了のトランザクションが残ることはありません。プロファイリングを開始する前に、クエリ チューニングはセッションのトランザクション状態も検査し、既にトランザクションが実行中の場合は実行を拒否します。そのため、クエリ チューニングが、ユーザー自身が開始した作業の中にネストしたり、干渉したり、ロールバックしたりすることはありません。すべては、ユーザー自身の資格情報と権限で既存のエディター セッション上で実行されるため、クエリ チューニングがデータに追加のアクセス権を取得することはなく、データに何も書き戻すこともありません。
クエリ最適化の対象範囲を拡大し、プレビューを公開します
当面の重点は、カバレッジと信頼性の向上です。エージェントが処理するチューニングパターンを拡張し、各推奨事項の根拠となる証拠を強化し、エンジンによる検証を統合することで、より多くの提案がユーザーに届く前にSingleStore独自の最適化ロジックと照合されるようにします。
SingleStoreクエリのチューニングを行っている方は、ぜひご協力ください。現在、パフォーマンスチューニングエージェントのプレビュー版を公開し、設計パートナーと連携して開発を進めています。クエリのチューニングを頻繁に行い、ワークフローにこのエージェントを組み込みたい方、そして弊社のエンジニアリングチームと協力したい方は、アカウントチームまたはサポートチームまでご連絡ください。エージェントを試用し、最も負荷の高いクエリに適用して、パフォーマンスが不十分な点をお知らせください。