はじめに
AIを活用したアプリケーションが主流になるにつれ、ベクトル検索はニッチな機能から重要なデータベース機能へと進化しました。レコメンデーションエンジン、セマンティック検索、RAG(検索拡張生成)アプリケーションのいずれを構築する場合でも、ベクトル演算のパフォーマンスはユーザーエクスペリエンスに直接影響します。
最近、SingleStoreのベクトル機能を、もう一つの人気の分析データベースであるClickHouseと比較する包括的なベンチマークを実施しました。その結果は、SingleStoreの統合アーキテクチャが、実稼働AIアプリケーションに求められる一貫した低レイテンシのパフォーマンスを実現する理由を実証しています。
ベンチマークの設定
公平な比較を行うため、45,466本の映画レコードからなる同じデータセットを使用して、AWS us-east-1の同等のクラウドインフラストラクチャ上で両方のデータベースをテストしました。各レコードには、all-mpnet-base-v2モデルを使用して生成された768次元のベクトル埋め込みが含まれています。これは、本番環境のセマンティック検索ワークロードを現実的に表現したものです
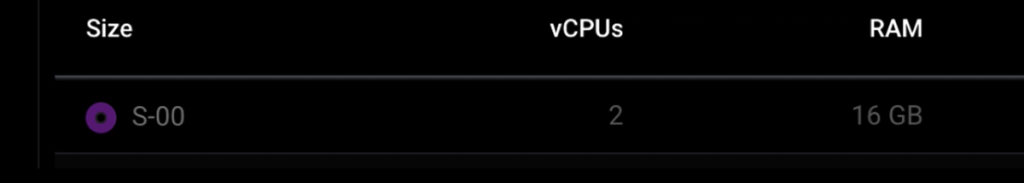
SingleStore 構成: フルマネージド クラウド サービスである Helios 上で実行される S-00 クラスター (16 GB RAM、2 vCPU)
ClickHouse構成: クラウドデプロイメント (16 GB RAM、4 vCPU) - 特にCPUリソースが2倍
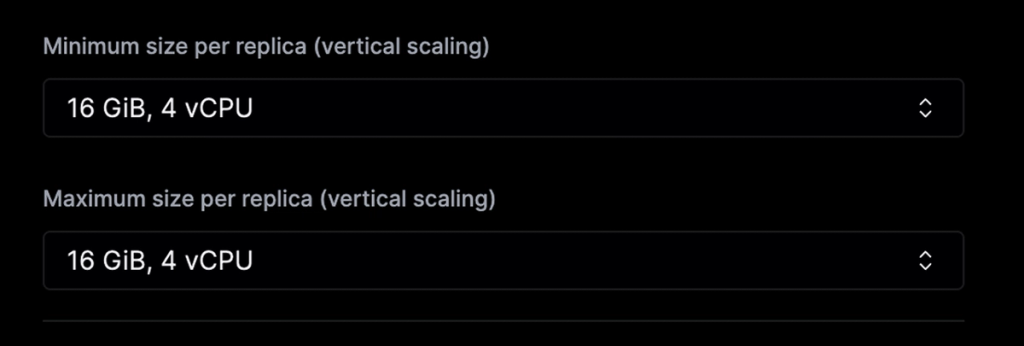
半分の vCPU で実行されているにもかかわらず、SingleStore はほとんどのテスト シナリオで一貫して ClickHouse に匹敵するか、それを上回りました。
スキーマ設計
現実的なセマンティック検索ワークロードを表す、Kaggleの45,466本の映画からなる実世界のデータセットを使用しました。スキーマは、本番環境のユースケースを反映するように設計されました。
埋め込みは、意味的類似性タスクでよく使用される all-mpnet-base-v2 モデルを使用して生成されました。SingleStore は、これらのベクトルを列指向ストレージに保存することで、最適な分析パフォーマンスを実現します。
テスト方法
プログラム的およびインタラクティブなパフォーマンス特性の両方を把握するために、テストを2つのフェーズに分けました
フェーズ1 — Pythonスクリプトのテスト:実際のアプリケーションの動作をシミュレートするPythonテストハーネスを構築しました。ユーザーが自然言語クエリ(例:「バスケットボールのようなスポーツに関する映画」)を入力すると、スクリプトはそれをデータベースに保存されている768次元に一致するベクトル埋め込みに変換します。次に、スクリプトは類似性クエリを実行し、応答時間を測定します。重要なのは、計測開始はデータベース接続とカーソルが確立された時点から始まり、結果行が書き込まれた時点で終了することです。これにより、接続オーバーヘッドや埋め込み生成から純粋なクエリ実行時間を分離できます。
フェーズ 2 - ポータル テスト: スクリプトのオーバーヘッドを排除し、プログラムによる結果を検証するために、各データベースのネイティブ Web ポータルを通じて直接クエリも実行しました。
コールドキャッシュとウォームキャッシュの処理
キャッシュの動作は実際のパフォーマンスに大きな影響を与えるため、両方のシナリオを測定しました。
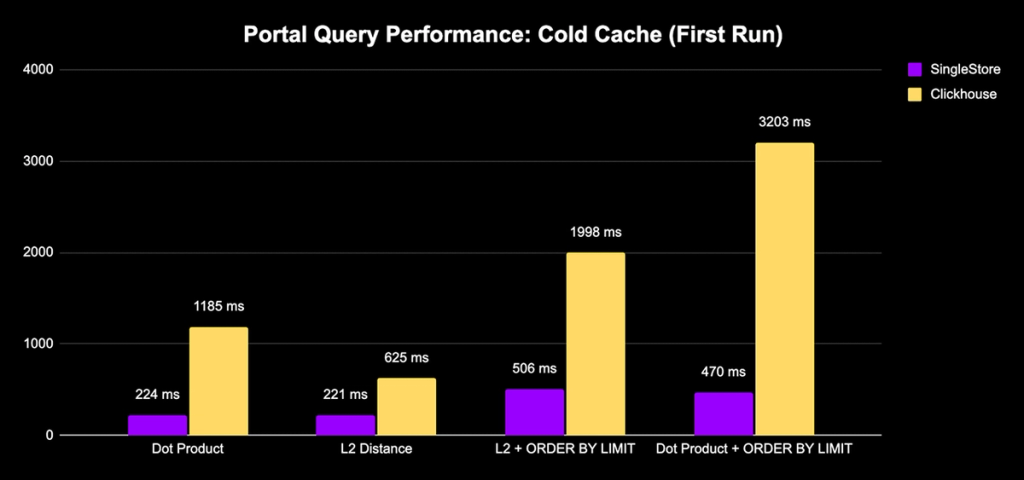
コールドキャッシュ(実行1):各テストシリーズの前に、クエリプランキャッシュをクリアし、オプティマイザーに新しい実行プランを強制的に生成させました。これは、初回実行クエリやシステム再起動後のクエリをシミュレートするもので、最悪のレイテンシを理解する上で非常に重要です。
ウォームキャッシュ(平均):各クエリを複数回連続して実行し、その結果を平均化しました。これは、頻繁に実行されるクエリの定常状態のパフォーマンスを表しています。
また、クエリチューニングやオプティマイザーヒントは使用しないという意図的な選択も行いました。すべてのクエリは、ほとんどの開発者がすぐに経験するデフォルトのオプティマイザー動作で実行されました。適用された最適化は、ドキュメントに記載されているインデックスの追加のみで、その結果は別途レポートされます。
主要なパフォーマンス結果
ドット積検索:すぐに使える高速化
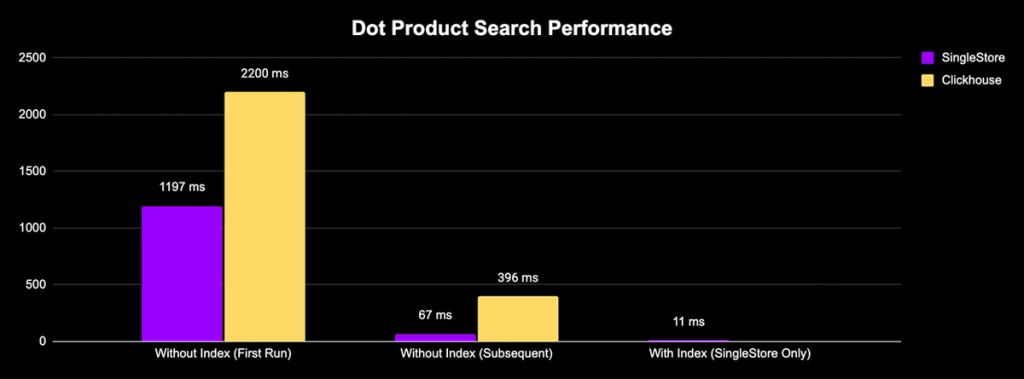
多くのレコメンデーションシステムの基盤となるドット積類似検索において、SingleStoreは最初のクエリの応答時間が1197ミリ秒であるのに対し、ClickHouseは2秒以上でした。これはコールドキャッシュではより高速です。
SingleStoreの DOT_PRODUCT インデックスを追加すると、クエリ時間は約70ミリ秒に短縮されました。ClickHouseは専用のドット積インデックスを提供していないため、この一般的なユースケースではパフォーマンスに大きなギャップが生じます。
L2/ユークリッド距離: 一貫したパフォーマンス
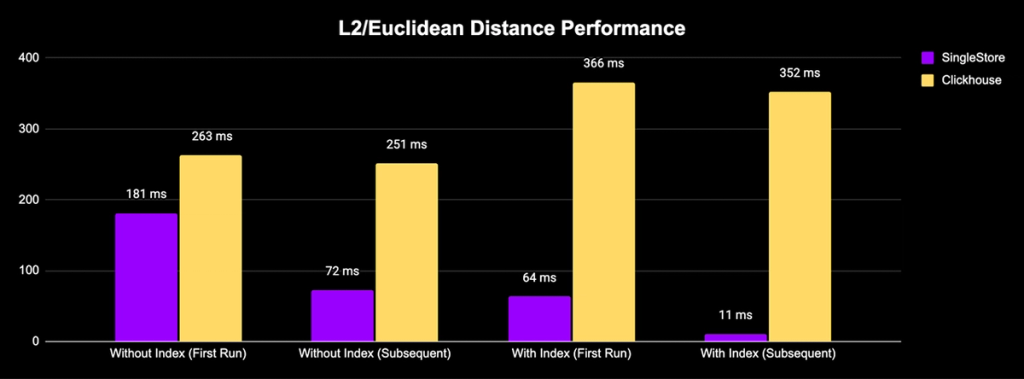
どちらのデータベースもL2距離計算を提供していますが、SingleStoreの方がより予測可能なパフォーマンスパターンを示しました。インデックスなしの場合、SingleStoreは約75ミリ秒でクエリを完了しましたが、ClickHouseでは241ミリ秒から366ミリ秒かかりました。
インデックスを使用すると、SingleStore は計算オーバーヘッドを削減しながらパフォーマンスを次のレベルに引き上げました。
同時実行性:実世界のパフォーマンスが重要になる場所
本番環境アプリケーションでは、一度に1つのクエリしか実行しないということはありません。当社のPythonテストハーネスには、並列負荷下での各データベースのパフォーマンスを明らかにする同時実行テストが含まれています。
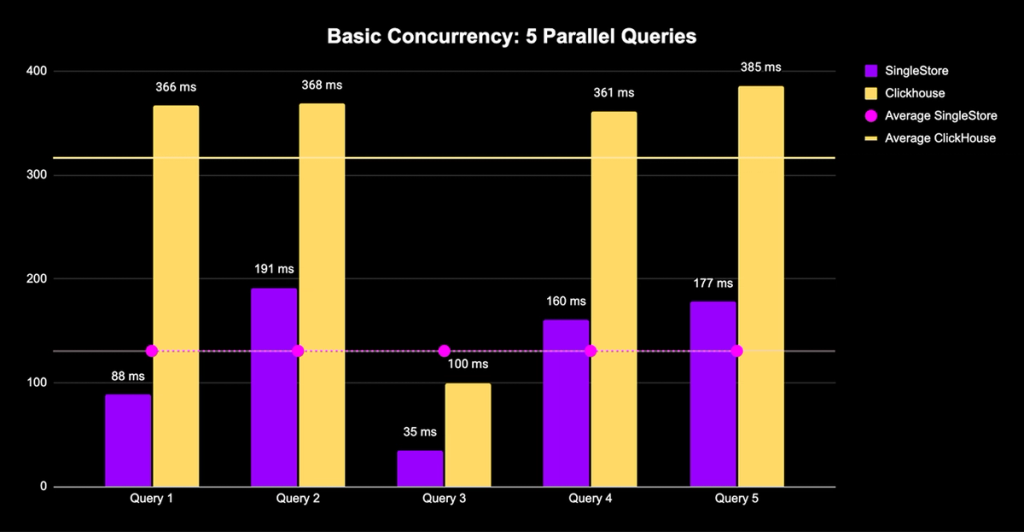
基本的な同時実行性(5つの並列クエリ):
5 つの類似クエリを同時に実行し、それぞれが異なるユーザー プロンプトに最も近い一致を検索しました。
SingleStoreのレイテンシは450~580ミリ秒とわずかなばらつきがありましたが、ClickHouseは540~810ミリ秒でした。さらに重要なのは、SingleStoreが半分のCPUリソースでこのパフォーマンスを実現したことです。
高度な同時実行性(持続的なバックグラウンド負荷):
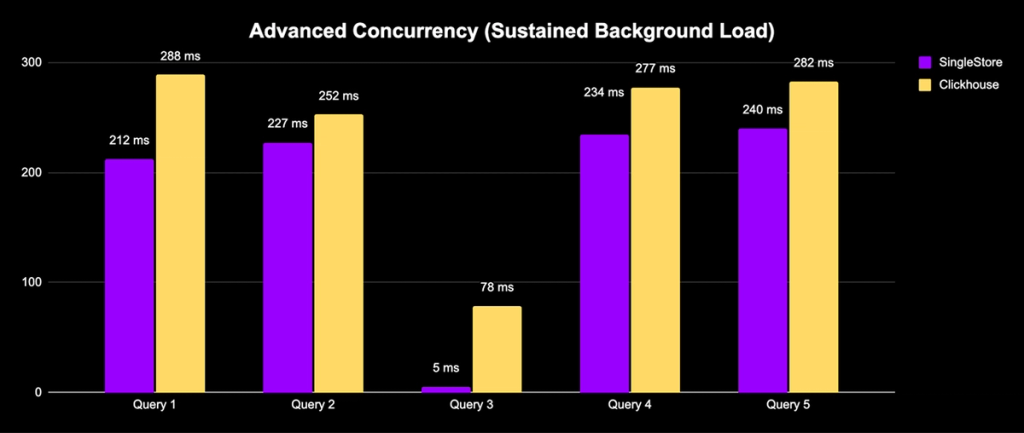
次に、より現実的なテストを実施しました。計測対象となるクエリごとに、バックグラウンドで4つのクエリが継続的に実行されました。スクリプトは5つのスレッドを生成し、各スレッドがクエリを5回実行している間、他のスレッドも同時に実行されました。これは、データベースが本番環境で実際に経験する、持続的な同時負荷下におけるパフォーマンスを測定するものです。
全体的に、SingleStore はより優れた同時実行パフォーマンスを示し、ワークロードに応じてクエリあたり 50 ~ 260 ミリ秒の改善が見られました。
複雑な分析クエリ
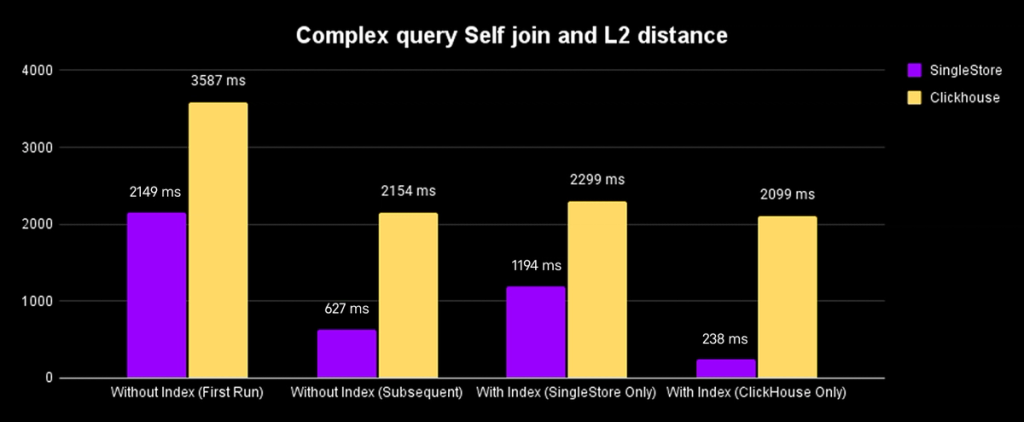
複数のベクトル演算を組み合わせた複雑なk近傍クエリもテストしました
- 768次元埋め込みを持つN個のピボット行を選択します。
- 各ピボットについて、他のすべての行と比較し、ドット積類似度とL2距離の両方を計算します。
- 各ピボットについて、L2距離で上位K近傍のみを返します。
どちらのデータベースも最初は2秒以上かかりました。しかし、SingleStoreの実行時間はその後の実行で最初の3分の1に短縮され、適切なインデックス設定により5分の1にまで短縮されました。ClickHouseでは、このシナリオではわずかな改善しか見られませんでした。
ポータルベースのクエリ結果
Pythonスクリプトの結果を検証し、スクリプトのオーバーヘッドを排除するために、各データベースのネイティブウェブポータルから直接同じクエリを実行しました。各テストの前に、プランキャッシュをクリアして最新の最適化を確保しました。
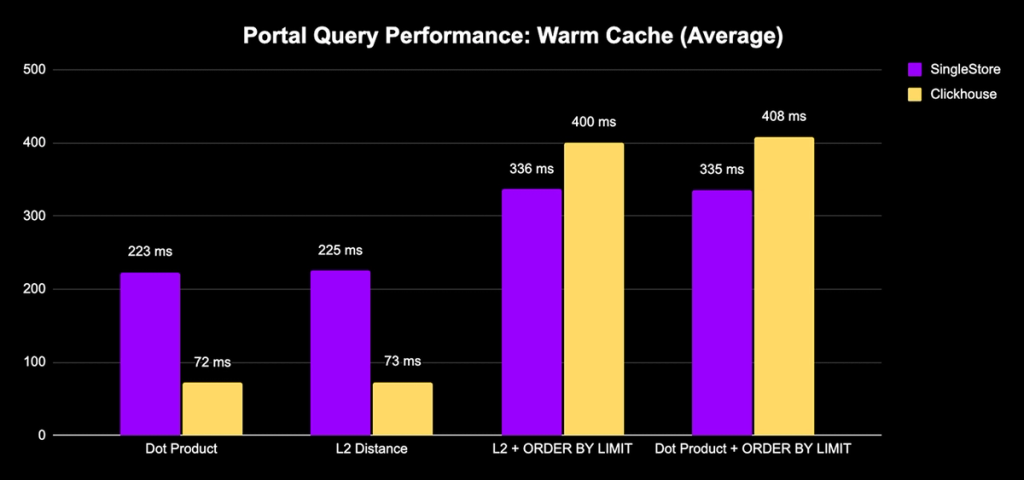
結果は明白です。SingleStoreは、ウォームキャッシュの性能を競争力のある水準に保ちながら、劇的に優れたコールドキャッシュのパフォーマンスを提供しています(初回実行時は3~7倍高速)。コールドスタートがユーザーエクスペリエンスに影響を与えるユーザー向けアプリケーションにとって、この差は非常に重要です。
SingleStore がベクトルワークロードに優れている理由
- ネイティブ ベクトル タイプ:SingleStore の専用の VECTOR データ型と関数 (DOT_PRODUCT、EUCLIDEAN_DISTANCE、COSINE_SIMILARITY) は、追加ではなく、根本から最適化されています。
- 柔軟なインデックス作成:複数の ANN インデックス タイプ (IVF_PQFS、HNSW) をサポートしているため、特定のアクセス パターンに合わせて最適化できます。
- 一貫したレイテンシ:最初のクエリでも 1000 回目のクエリでも、SingleStore はさまざまな負荷下で予測可能なパフォーマンスを提供します。
- 統合プラットフォーム:ベクトル検索とトランザクション データ、分析、全文検索を単一のデータベースに統合します。複雑なデータ パイプラインは必要ありません。
結論
AIを活用したアプリケーションを構築するチームにとって、データベースの選択は重要です。SingleStoreは、コールドクエリとウォームクエリの両方で一貫したパフォーマンス、優れた同時実行処理、包括的なベクトルインデックスオプションを備えているため、本番環境のベクトルワークロード、特に大規模で予測可能なレイテンシーが必要な場合に最適な選択肢となります
SingleStoreがベクトルデータでどのように機能するかを体験してみませんか?今すぐ無料トライアルを開始して、統合されたリアルタイムデータアーキテクチャがAIアプリケーションにもたらす違いを体験してください。
データセット: Kaggleの映画データセット
無料トライアルを開始する →