検索拡張生成(RAG)は、言語モデルを外部知識に基盤づけるための基盤技術となっています。従来のRAGパイプラインは、ベクトル検索を利用して関連テキストチャンクを抽出し、それらをLLMに入力して回答を生成します。GraphRAGは、これをさらに一歩進め、エンティティと関係性を抽出し、明示的なナレッジグラフを構築し、グラフを考慮した検索を用いてマルチホップ推論とより豊かで忠実な回答をサポートします。
今日は、RAG がどのように動作するのか、そしてなぜ GraphRAG が単純な RAG を簡単に置き換えるのかを理解します。
RAGとは?
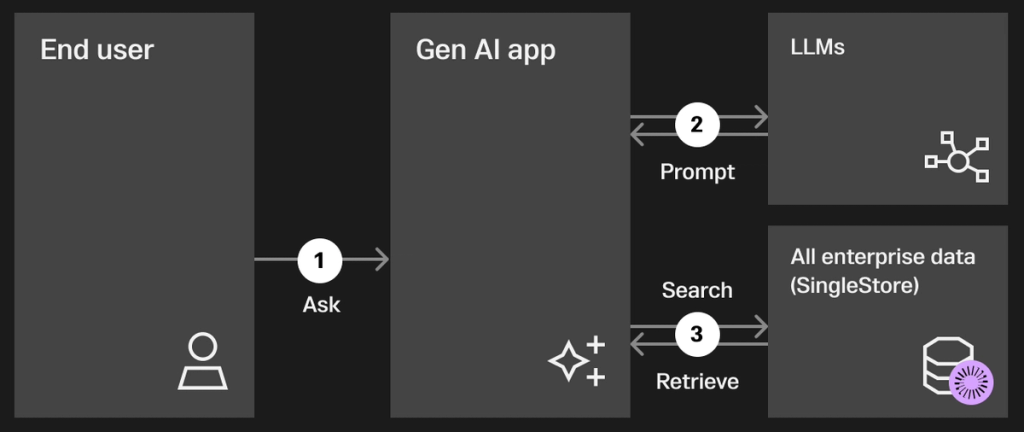
大規模言語モデル(LLM)は通常、ハルシネーションを起こします。つまり、検証されていない応答、偽の応答、でっち上げた回答などを独自に生み出すことがあり、これは深刻な問題です
これらのモデルは、AIアプリケーションで直接使用しても役に立ちません。AIアプリが適切に動作し、文脈的に適切な情報や応答を確実に取得できるようにするには、LLMのハルシネーション現象を軽減する技術が必要です。主な技術としては、迅速なエンジニアリング、ファインチューニング、そして検索拡張生成(RAG)があり、その中でRAGは現時点で最良の選択肢と考えられています。RAGでは、データベース(多くの場合、ベクトルデータベースと呼ばれます)を介してカスタムデータを拡張するため、LLMは通常、データベースを参照して関連するチャンクを検索し、文脈的に適切な応答をプロビジョニングできます。RAGアプローチを強化する技術は数多くありますが、ここでは詳しく説明しません。
さらに、従来のアプローチと GraphRAG アプローチの両方を理解しましょう。
従来のRAG
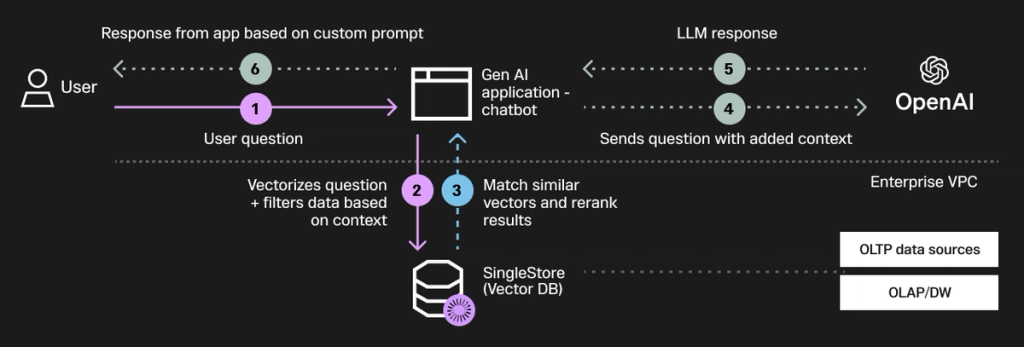
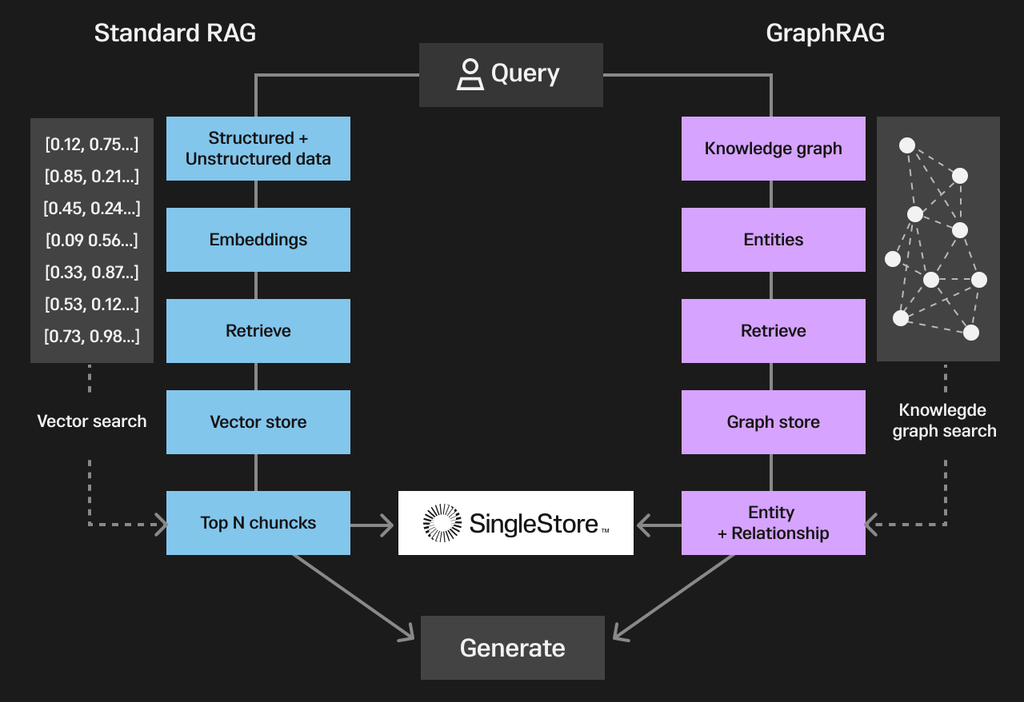
従来のRAGは、ベクトル埋め込みと類似度検索を用いて、最も関連性の高いテキストチャンクを取得します。このアプローチでは、文書は小さなセグメントに分割され、埋め込みモデルを用いて高次元ベクトルに変換され、ベクトルデータベースに保存されます。クエリが到着すると、同様に埋め込まれ、コサイン類似度などの類似度指標を用いて保存されているベクトルと比較されます。システムは、クエリとの意味的な近さに基づいて、上位k個の最も類似したチャンクを取得します。取得されたこれらの文章は、LLMのコンテキストウィンドウに追加情報として挿入されます。単純な事実検索や質問応答タスクには効果的ですが、従来のRAGは、マルチホップ推論、エンティティ間の複雑な関係性の理解、または複数の文書セクションに散在する情報の統合を必要とするクエリには苦労することがあります。
従来のRAGの仕組み
古典的なRAGパイプラインはシンプルで洗練されており、多くの場合効果的です。重要な手順は次のとおりです。
- ドキュメントを取り込み、チャンクに分割します (トークン化とチャンキング)。
- 埋め込みモデルを使用して、各チャンクをベクトル埋め込みに変換します。
- 埋め込みをベクトルストアまたはベクトルデータベースに保存します。
- ユーザー クエリでは、クエリを埋め込み、ベクトル検索を実行して上位 k 個のチャンクを取得します。
- 取得したチャンクを LLM に渡し、その条件に基づいて最終的な回答を生成します。
このアプローチにより、RAGは拡張性が高く、実装も迅速です。ベクトル検索は、クエリと意味的に類似したテキストの検索に優れており、多くの場合、単純な情報ニーズに対して高品質な回答が得られます。
伝統的なRAGが苦戦する場所
長所があるにもかかわらず、従来の RAG には限界もあります。
- 弱いマルチホップ推論: ベクトル検索は、個々に関連するチャンクを取得しますが、チャンク間で情報がどのように接続されるかを明示的にキャプチャしません。
- エンティティの曖昧性の解消が不十分: クエリで特定のエンティティとその関係を理解する必要があるとき、単純な類似性検索では必要なリンクが見つからない可能性があります。
- ハルシネーションリスクの増大: 事実をリンクするグラフ構造が存在しない場合、LLM は取得したスニペットを誤って結合する可能性があります。
- 出所が限られている: 複数の関連する事実から最終的な答えがどのように組み立てられたかを追跡することが困難です。
GraphRAG
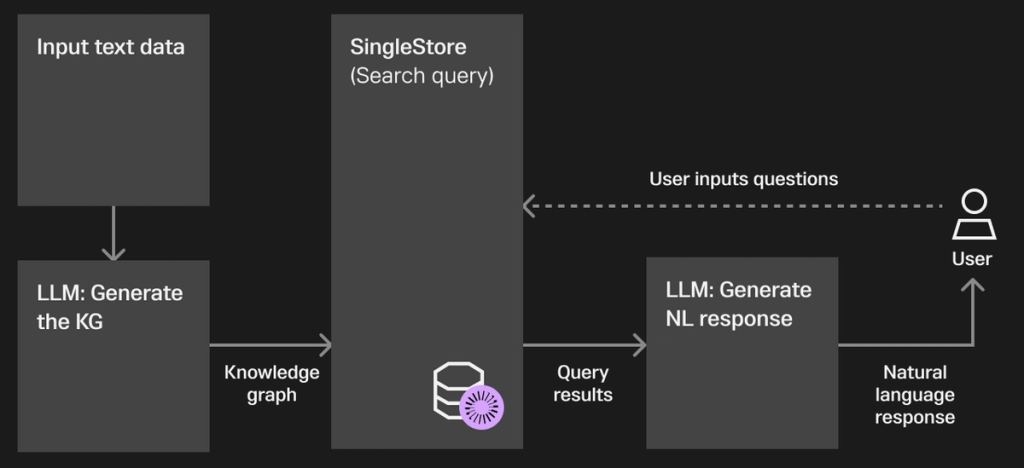
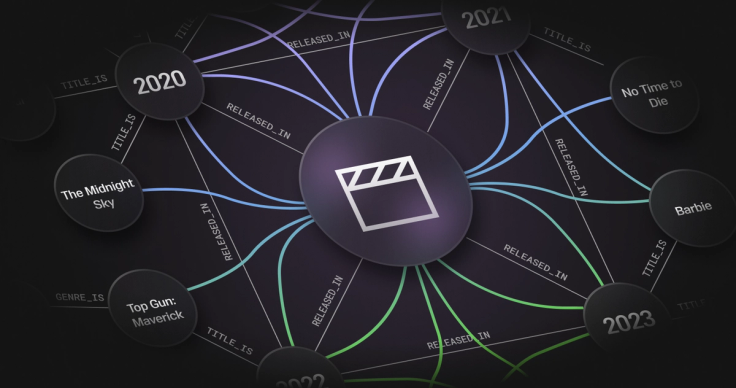
GraphRAGは 、ドキュメントをエンティティと関係性に変換し、それらをナレッジグラフとして保存し、エンティティ間のつながりをトラバースできるグラフ対応の検索を実行します。このアプローチは、まず非構造化テキストから構造化情報を抽出し、エンティティ(人、場所、概念)とそれらを結ぶ関係性を特定します。これらの要素はナレッジグラフ内のノードとエッジを形成し、システムが情報がどのように相互に関連しているかを理解できるようにします。検索中、GraphRAGはマルチホップトラバーサル、関係性フィルタリング、コミュニティ検出などの高度な操作を実行し、文脈に富んだ情報を収集します。この構造的理解により、GraphRAGは複数の関連する事実を網羅した推論、暗黙的なつながりの発見、そしてナレッジベース内のより広範なコンテキストと相互依存性を考慮したより包括的な回答の提供を必要とする複雑なクエリにおいて優れた性能を発揮します。
GraphRAGの典型的なワークフロー:
- ソース テキストをチャンク化し、各チャンクに対してエンティティ抽出と関係抽出を実行します。
- エンティティ (人、組織、日付、製品、概念) のグラフ ノードを作成します。
- 明示的な関係 (acted_in、directed_by、born_on) を表すエッジを作成します。
- テキスト チャンクまたはポインタをノード/エッジに添付して、構造化された関係と元のテキスト証拠の両方を取得できるようにします。
- クエリでは、グラフを考慮した検索を実行します。つまり、クエリで言及されているエンティティを識別し、接続された証拠についてグラフをトラバースし、最も関連性の高いノード/エッジに基づくチャンクを収集します。
- この構造化されたマルチホップ証拠を LLM に渡して回答を生成します。
GraphRAGが推論を改善する理由
GraphRAG は、RAG ワークフローに 3 つの重要な利点をもたらします。
- 明示的なマルチホップ パス: 質問で事実の連鎖が必要な場合 (「俳優 X がキャラクター Y を演じた映画を監督したのは誰か?」)、グラフ トラバーサルでパス (俳優 → キャラクター → 映画 → 監督) を明示的にたどることができるため、盲目的な類似性マッチングを回避できます。
- より優れたエンティティのグラウンディング: グラフはエンティティを明確に表現し (例: 「Alex」という名前の複数の人物)、それらを一意の識別子とコンテキストに接続して、あいまいさを軽減します。
- より強力な出所と追跡可能性: 各回答は特定のノード、エッジ、テキスト チャンクまで遡ることができるため、忠実性と解釈可能性が向上します。
実例: 俳優と映画のナレッジグラフ
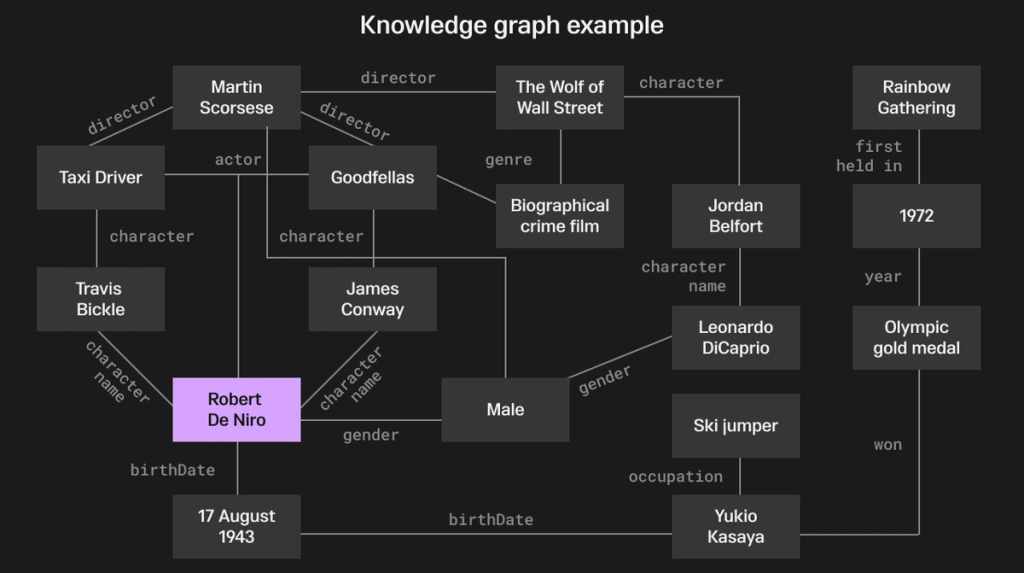
俳優と映画に関する小さなナレッジグラフを構築することを想像してみてください。ノードは人物と映画を表し、エッジは出演者や監督といった関係性を表します。このグラフの一部は次のようになります。
ノード: ロバート・デ・ニーロ
エッジ:acted_in → タクシードライバー(キャラクター:トラヴィス・ビックル)
エッジ: acted_in → グッドフェローズ (キャラクター: ジミー・コンウェイ)
ノード:マーティン・スコセッシ
エッジ:directed_by → グッドフェローズ(監督:マーティン・スコセッシ)
「『グッドフェローズ』でロバート・デ・ニーロと共演した監督は誰ですか?」のように、複数の関係性にまたがる質問をする場合、グラフ探索は正確なパスと証拠チャンクを返します。LLMは構造化された証拠を受け取ることで、推測を減らし、より正確な多段階推論を可能にします
単一データベースRAG + GraphRAGシステムの実装
実用的なアーキテクチャでは、ベクトル埋め込みとグラフデータの両方を単一の統合データベースに保存できます。これにより、導入が簡素化され、別々のシステム間の同期に伴う煩わしさを回避できます。
統合 RAG システムのコア コンポーネント:
- ドキュメント取り込みモジュール: PDF またはその他のドキュメントを読み取り、チャンクに分割し、各チャンクの埋め込みを生成します。
- エンティティと関係の抽出モジュール: LLM または NLP パイプラインを実行して、各チャンクからエンティティと関係を抽出し、グラフノードとエッジを出力します。
- 統合データベース: 従来の RAG ではベクトル埋め込みをテーブルに保存し、GraphRAG ではノード、エッジ、ノードとチャンク間のマッピングをテーブルに保存します。
- 検索エンジン:ベクトル検索とグラフ検索の両方を実装しています。エンジンは両方のパイプラインを並列実行して比較することができます。
- LLM 審査員: 関連性、忠実性、完全性、推論などの指標に基づいて回答を採点し比較する LLM ベースの評価者。
- ユーザー インターフェース: シンプルなインターフェースにより、システムをクエリし、検索証拠を表示し、従来の RAG と GraphRAG の出力を並べて比較することができます。
なぜ単一のデータベースなのでしょうか?
ベクトルとグラフの両方のプリミティブをサポートする単一のデータベースを使用することで、運用上の複雑さが軽減されます。2つのストアの同期が不要になり、開発エクスペリエンスが簡素化されます。また、ベクトルテーブル(埋め込みとチャンク)とグラフテーブル(ノード、エッジ、ノードとチャンクのリンク)の両方を検査してデバッグや分析を行うことも容易になります。
SingleStoreは、この統合アプローチに特に適しています。ベクトル検索とグラフ操作の両方をネイティブにサポートする分散SQLデータベースであるSingleStoreは、個別のインフラストラクチャを維持する必要性を排除します。列指向ストレージエンジンは、高次元ベクトルを効率的に処理すると同時に、SQL拡張機能を通じてグラフトラバーサルクエリをサポートします。SingleStoreのインメモリ行ストアとディスクベースの列ストアアーキテクチャは、リアルタイムの類似性検索と複雑なグラフクエリに必要なパフォーマンスを提供します。
さらに、SingleStore の ACID 準拠により、ベクトル演算とグラフ演算の両方でデータの一貫性が確保され、水平方向のスケーラビリティにより、アーキテクチャを変更することなく、増大するナレッジベースに対応できます。ベクトル類似度結果とグラフトラバーサルの結合を単一のクエリで実行できるため、複数のデータベースをオーケストレーションする場合と比較して、アプリケーションロジックが大幅に簡素化され、レイテンシが短縮されます。
チュートリアル: RAG と GraphRAG の実践的な比較
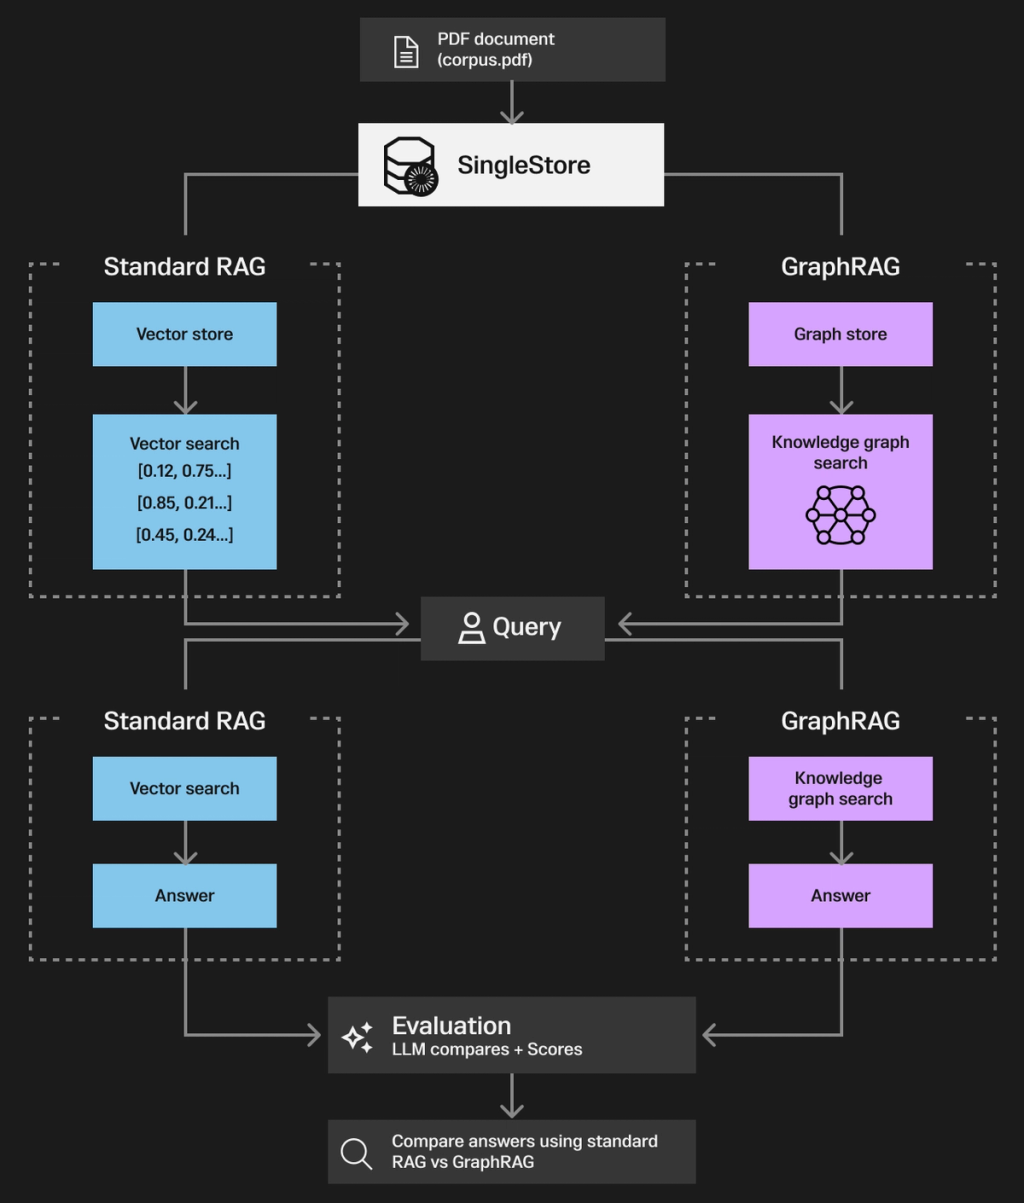
同じコーパスを 2 つの並列パイプラインに入力することで、両方のアプローチを評価できます。
従来の RAG: チャンク → 埋め込み → 保存 → ベクトル取得 → LLM
GraphRAG: チャンク → エンティティ/リレーションの抽出 → グラフの構築 → グラフの取得 → LLM
両者が回答を出した後、LLM 審査員が定義された基準に基づいて評価します。
- 関連性: 回答は質問に対応していますか?
- 忠実性: 主張は取得した証拠によって裏付けられていますか?
- 完全性: 回答は必要な側面とエッジケースをカバーしていますか?
推論: 回答は正しい論理的手順とマルチホップ推論を示していますか?
多くのデモンストレーションにおいて、GraphRAGは関連性のある事実と明確な証拠の連鎖を浮き彫りにするため、完全性と推論性において勝っています。審査員は各指標について定性的なフィードバックと数値スコアの両方を返すことができるため、2つのRAGバリアントを定量的に比較することが可能です。
簡単な比較例を再現する
単純な複製では以下を使用します。
- 知識源としての単一の PDF 研究論文。
- 埋め込みとグラフ構造のための統合データベース SingleStore。
- 質問したり、取得したチャンク、グラフ ノード、エッジを視覚化したりするための小さな UI。
デモを実行する手順:
- ベクトルとグラフのようなテーブルの両方をサポートする SingleStore データベース インスタンスを作成またはサインアップします。
- データベース接続の詳細 (ホスト、ポート、ユーザー名、パスワード、データベース名) を入力します。
- PDF を取り込み、テキストをチャンクに分割し、埋め込みを生成して、ベクトル テーブルに保存します。
- チャンク全体でエンティティとリレーションの抽出を実行し、グラフ テーブル (ノード、エッジ、ノード チャンク リンク) に入力します。
- アプリを起動して質問を投げかけてください。システムは従来のRAGパイプラインとGraphRAGパイプラインの両方を並列に実行し、結果、取得した証拠、そしてLLM審査員の評価を表示します。
代表的な実行では、再帰が言語モデルにおける推論をどのように改善するかという質問に対して、2つの回答が得られました。LLM審査員は両方の回答を評価し、GraphRAGは連結されたチャンク全体にわたってマルチホップの結論と実証結果を参照できるため、完全性と推論の点でGraphRAGに高い評価を与えました。
これは、従うことができるすべてのコードを含む完全なリポジトリです:https://github.com/pavanbelagatti/TraditionalRAG-Vs-GraphRAG
GraphRAGと従来のRAGのどちらを選ぶべきか
次の場合には従来の RAG を使用します:
- タスクは主にシングルホップ検索です: 短い事実の検索、FAQ への回答、またはローカル コンテキストのドキュメントの要約などです。
- レイテンシーとシンプルさが最優先事項です。
- 複雑なエンティティ リンクを必要としない、比較的小規模でフラットなコーパスがあります。
GraphRAGを使用する場合:
- クエリでは、ドキュメントまたはセクションにわたって複数のファクトを連鎖する必要があります。
- エンティティの曖昧さ回避と出所は重要です。
- 説明可能性と追跡可能な推論パスが必要です (法律、医療、または科学のワークフロー)。
制限事項と実装上のトレードオフ
GraphRAGは強力ですが、万能薬ではありません。以下のトレードオフを考慮してください。
- グラフ抽出の品質:グラフの品質は、エンティティとリレーションの抽出モデルの品質に依存します。ノードまたはエッジの作成にエラーがあると、誤ったパスが生成されます。
- インデックス作成コスト:グラフの構築と維持には、単純な埋め込みに比べて追加の前処理とストレージが必要です。
- 複雑さ:グラフ トラバーサル ロジックと接続された証拠のランク付けにより、実装の複雑さが増します。
- スケーラビリティ:大規模なグラフでは、大規模な高速移動と効率的な取得を保証するために慎重な設計が必要です。
効果的なGraphRAGシステムを構築するためのヒント
- 堅牢な固有表現抽出モデルと関係抽出モデルを活用します。ヒューリスティックルールと機械学習を組み合わせることで、再現率と精度を向上させます。
- 構造化グラフと生のテキストチャンクへの参照の両方を保存します。グラフノードは検証可能性のために元の証拠を参照する必要があります。
- LLM に渡す前に、パス関連性スコアとテキスト証拠の品質の組み合わせによってグラフ パスをランク付けします。
- LLM ジャッジまたは人間による評価を使用して、どの検索ヒューリスティックが最適なダウンストリーム回答を生成するかを調整します。
- グラフ スキーマを柔軟に保ちます。ドメインが異なれば、必要なエンティティとリレーションの種類も異なります。
結論
RAGは、大規模言語モデルをグラウンディングするための基礎的な手法です。従来のRAGは高速かつシンプルですが、GraphRAGはエンティティと関係性を明示的にモデル化することで、より豊かな推論を可能にします。マルチホップ推論、解釈可能性、そして正確な来歴が求められる問題においては、GraphRAGの方がより強力なアプローチとなります。
実用的なGraphRAGシステムの構築は簡単です。ドキュメントを取り込み、エンティティ/リレーションを抽出し、埋め込みとグラフデータを統合されたバックエンドに保存し、LLMジャッジを用いて出力を評価するだけです。このパターンは、関連性だけでなく検証可能で論理的に一貫性のある回答を生成します。
実験が鍵となります。両方のアプローチを専門分野のコーパスで並行して実行し、関連性、忠実性、完全性、そして推論性を測定してみてください。多くの場合、GraphRAGはより包括的で妥当な回答を提供します。まさに正確性が重要となる場面で必要な情報です。