データベースは今やクラウドネイティブサービスのように振る舞うことが期待されている
組織がKubernetesを標準として採用するにつれて、期待値も変化してきました。データベースはもはや特別な存在として扱われることはなく、他のワークロードと同様に、Kubernetes上のステートフルなワークロードやステートフルなアプリケーションであっても、宣言的なデプロイメント、安全なアップグレード、均一なスケーリング、明確な運用パターンをサポートすることが求められています。
しかし、Kubernetes上で分散データベースを本番環境で運用することは、ステートレスなサービスを運用することとは根本的に異なります。本当に重要なのは、デプロイメントではなく運用です。ノードのサイズはどのように決めるべきか?データはどこに保存すべきか?中断なくアップグレードを行うにはどうすればよいか?コンポーネントが故障した場合、どうなるのか?
実際には、チームはSingleStoreの運用開始には自信を持っていることが多いようです。難しいのは、最初のアップグレード後、最初のノード障害や、ワークロードが予想以上に急速に増加した時などに、その自信を維持することです。この記事では、その自信を獲得し、維持するために実際に必要なことに焦点を当てます。
この記事の内容
- 長期的な安定性を左右するアーキテクチャ上の決定
- アップグレード、障害、スケーリングに関する運用パターン
- 最も重要な指標と復旧ワークフロー
- よくある落とし穴とその回避方法
本番環境での信頼性は、Kubernetesの限界を知ることから始まる
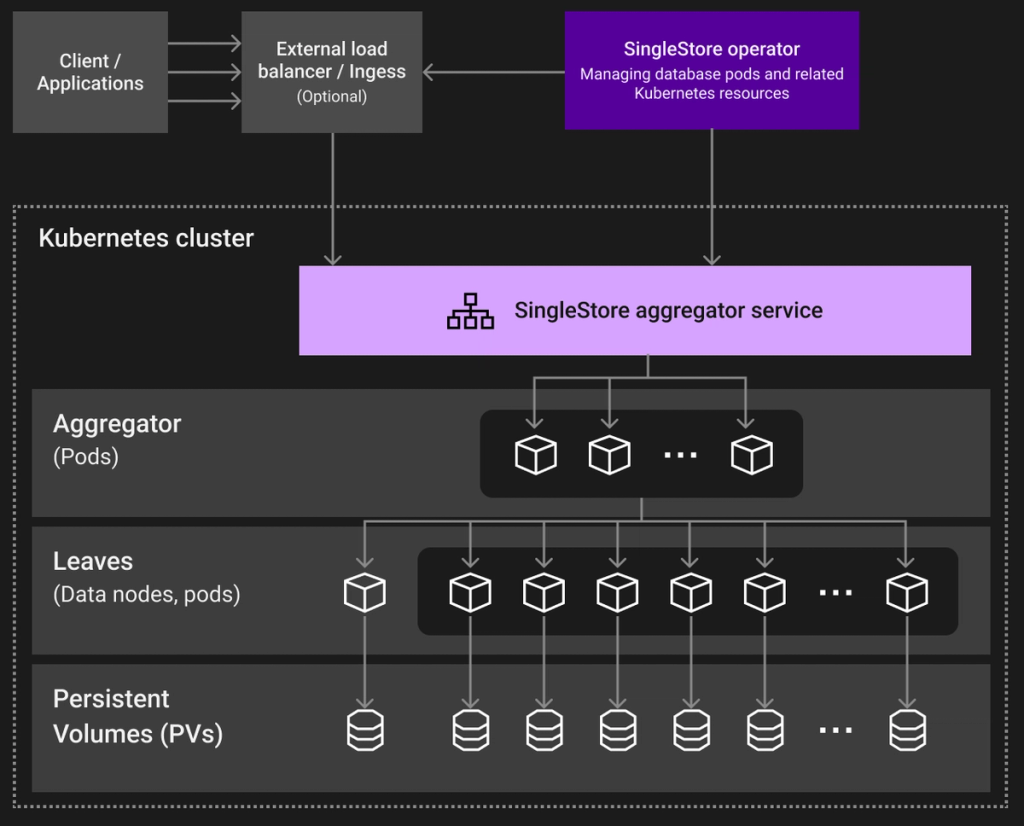
Kubernetesは、ライフサイクル管理、スケジューリング、インフラストラクチャ自動化のための強力な基本機能を提供します。しかし、分散システムにおける永続ストレージのパフォーマンス、データの局所性、リカバリ動作といったデータベース固有の課題を解決するものではありません。これらの責任は、依然としてプラットフォームとその運用チームが負うことになります。
SingleStoreは、Kubernetes Operatorを通じてこのギャップを埋めます。Kubernetes Operatorは、SingleStoreのアグリゲーター/リーフアーキテクチャに特有の運用パターンをエンコードするKubernetesネイティブのコントローラーです。アグリゲーターとリーフのライフサイクルを処理し、障害を管理し、ローリングアップグレードを実行することで、Kubernetesの基本機能を分散データベースやその他のステートフルアプリケーションのニーズに適合させ、宣言的なクラスタ管理を可能にします。
本番環境に対する自信は、この関係性を明確に理解することから生まれます。オペレーターは操作を大幅に簡素化しますが、情報に基づいた設計判断の必要性をなくすものではありません。
オペレーターを一文で表すと
SingleStore Kubernetes Operatorは、ライフサイクル、アップグレード、障害処理といった運用パターンをコード化しますが、ストレージ、トポロジー、ノードサイジングに関する適切な判断を代替するものではありません。これらの判断は、引き続きユーザー自身が行う必要があります。
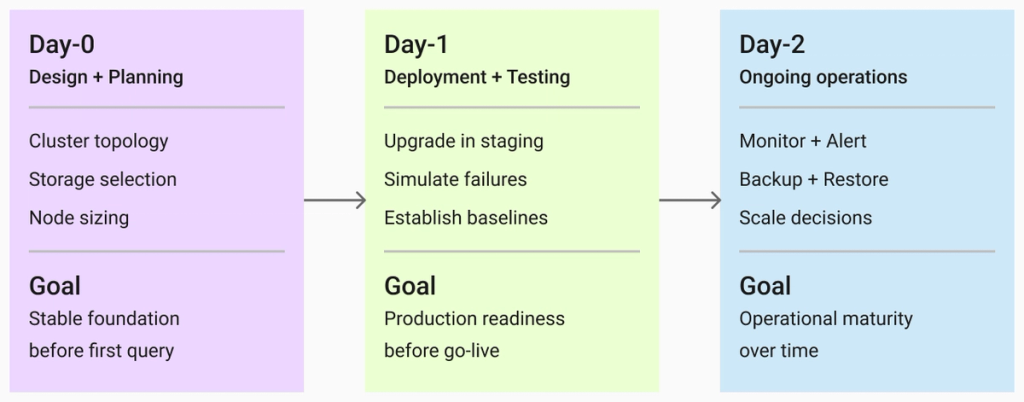
初日の決定が長期的な安定性を決定づける
本番環境は、最初のクエリが実行される前に下された決定によって形作られます。
クラスタ トポロジー
SingleStoreはアグリゲーターとリーフを分離し、それぞれに明確な役割を与えます。アグリゲーターはクエリの調整と並行処理を担当し、リーフはデータの保存と実行を担当します。これらの役割は、クラスタ仕様 (sdb-cluster.yaml)を使用して宣言的に構成されます。
ストレージ
Kubernetesは複数のストレージオプションを提供していますが、それらはパフォーマンスと動作において大きく異なります。リーフノードは、分析ワークロードとリカバリ操作をサポートするために、一貫性のある高スループットのストレージを必要とします。
ノードサイズ設定
CPU、メモリ、インスタンスの選択は、クエリの実行とシステムの安定性に影響を与えます。SingleStoreのシステム要件と推奨事項に従うことで 、安定したパフォーマンスが確保され、リソースの競合を回避できます。分析ワークロードの場合、通常はメモリが制約となります。リーフには、クエリの実行だけでなく、Universal Storageのバッファプールやバックグラウンドでの圧縮タスクのための余裕も必要です。
トポロジー、ストレージ、ノードサイズは密接に関連しています。これらを初期段階で明確に定義し、マニフェストに記述することで、再現性と信頼性を兼ね備えた基盤を構築できます。
初日と2日目の作戦こそが、実際に自信が築かれる場所である
システムは、デプロイが成功したからといって本番環境に対応できるとは限りません。特にKubernetes上でステートフルなワークロードを扱う場合はなおさらです。本番環境に対応できるのは、システムが変化に対して確実に応答できるようになった時です。
アップグレード
アップグレードはその良い例です。SingleStore Operatorを使用すると、アップグレードを制御されたローリング操作として実行できます。ノードは段階的に更新されるため、クラスタが適切なサイズに調整されていれば、クラスタの可用性を維持できます。
重要:テストされていないOperatorアップグレードを本番環境で実行しないでください
- Operatorのアップグレードは、本番環境で実行する前に必ずステージング環境でテストすることをお勧めします。Operatorのリリースノートには、アップグレードの動作変更点が記載されており、テストされていないOperatorバージョンを本番環境に導入することは、回避可能なリスクです。
- OperatorとSingleStoreのイメージバージョンを定義されたリリースに固定してください。singlestore /node:latestの使用は避け 、本番環境で使用する前にステージング環境で全てのアップグレードを検証してください。
障害処理
ノードが利用不能になると、Kubernetes は代替ポッドをスケジュールし、オペレーターがリバランスまたはリカバリをトリガーします。しかし、リカバリの速度と影響、そして全体的な高可用性は、ストレージ層に大きく依存します。ネットワークストレージからリーフのデータを復元するには、ローカル PV を再接続するよりも大幅に時間がかかる場合があり、これはクラスタがフル稼働できる時間に直接影響します。
本番稼働前に、さまざまな障害シナリオを想定して計画を立て、ステージング環境で実行してください。
スケーリング
SingleStoreクラスタは、リーフによるデータ容量とアグリゲーターによるクエリ同時実行性という2つの次元でスケーリングします。これらはKubernetes構成を介して個別に調整できるため、ワークロードが1つの次元でのみ増加する場合に非常に便利です。
どんなドキュメントも、これらのシナリオを自分で実行することに取って代わるものではありません。アップグレードのテスト、障害のシミュレーション、スケーリング動作の観察を行うことで、単に読むだけでは得られない真の自信が築かれます。
可観測性と復旧性は譲れない
可視性がなければ、いかなる本番システムも安定して動作することはできません。そして、Kubernetes 上の SingleStore の場合、一般的なインフラストラクチャ メトリクス以外にも、監視する価値のある特定のシグナルが存在します。
重要な指標
インフラストラクチャ側では、CPU使用率、メモリ負荷、ディスクI/O、ネットワークスループットはすべてPrometheus、Grafana、Datadogと自然に統合されます。しかし、データベース層では、問題を最も早く検出できるメトリクスは次のとおりです。
- アグリゲーターにおけるクエリの同時実行数とキューの深さ - 同時実行数の制限に近づいているかどうかがわかります
- リーフ上のディスク書き込みスループットと圧縮遅延 - バックグラウンドタスクが追いついているかどうかを示します
- ノードイベント発生後のリーフの再バランス時間
必要になる前に基準値を設定しておきましょう本番環境へのトラフィックが発生する前に、ステージング環境で監視を設定し、ベースラインとなる指標を確立しておきましょう。本番環境で異常が発生した場合、基準となる指標が必要になります。基準がないと、推測に頼るしかありません。
バックアップとリカバリ
SingleStoreは、一貫性のあるバックアップ戦略をサポートし、クラウドストレージシステムと統合します。さらに重要なのは、バックアップだけでなく、復元ワークフローも検証することです。
復元したことのないバックアップは想定です
復旧訓練を定期的に実施してください。プレッシャーのかかる状況下で一度も実行したことのない復旧プロセスは、安全策ではなく、単なる仮説に過ぎません。
よくある落とし穴はたいてい予測できる
私がよく目にする3つの落とし穴
- メモリに対してストレージ容量が不足している。リーフノードは、Universal Storageとバックグラウンドタスクをサポートするために、十分なディスク容量と書き込みスループットを必要とします。負荷がかかると、I/O飽和が顕在化し、事後的に診断するのが困難になります。
- Kubernetesをデータ局所性のための完全なソリューションとして扱っている。ノード間のネットワークトラフィックには依然としてコストがかかります。Shard Keyとクラスタトポロジを調整して、共通の結合と集約におけるノード間のシャッフルを最小限に抑えます。現実的なワークロードでテストすると、合成ベンチマークでは見逃される局所性の問題がすぐに明らかになります。
- テストされていないOperatorのアップグレードを本番環境で実行しないでください。バージョンを固定し、リリースノートを読み、必ず最初にステージング環境でテストを行ってください。
本番環境準備への実践的な道筋
導入段階から本番環境への移行には、全面的な設計変更は必要ありません。必要なのは、規律ある検証です。
実際のワークロードを想定したクラスタから始めましょう。負荷がかかった状態でストレージのパフォーマンスとノードのサイズを検証します。障害発生シナリオをシミュレーションし、復旧動作を観察します。ステージング環境でアップグレードワークフローをテストします。必要になる前に監視機能を統合し、ベースラインメトリクスを確立します。
生産開始準備チェックリスト
✓ 現実的な負荷条件下でストレージのパフォーマンスとノードのサイジングを検証する
✓ ノード障害をシミュレートし、復旧時間とクラスタの動作を観察する
✓ 使用予定のオペレーターバージョンと全く同じバージョンで、ステージング環境で完全なアップグレードサイクルをテストする
✓ Prometheus/GrafanaまたはDatadogと統合し、ベースラインメトリクスを取得する
✓ 本番稼働前にバックアップからの復元訓練を実施する
このプロセスは複雑である必要はありませんが、意図的に行う必要があります。私の経験では、ステージング検証を省略するチームは、本番環境で予期せぬ問題に遭遇する可能性が最も高く、しかもそれらの問題は容易に予測できたはずのものが多いのです。
すべてのチームが運用ライフサイクル全体を管理したいわけではない
Kubernetesは柔軟性と制御性を提供する一方で、継続的な責任も伴います。具体的には、アップグレードの管理、障害への対処、パフォーマンスの調整、そして長期的な信頼性の維持などです。
SingleStore Heliosは、従来とは異なるアプローチを提供します。ライフサイクル管理と運用上の複雑さをサービスとして処理する、完全マネージド型のエクスペリエンスです。これにより、チームはインフラストラクチャではなくデータとワークロードに集中でき、一貫したパフォーマンスと信頼性を維持しながら、価値実現までの時間を短縮できます。
セルフマネージドかHeliosか:どちらを選ぶべきか
- チームが運用面での成熟度を備え、インフラストラクチャ、配置、アップグレードのタイミングを完全に制御したい場合は、Kubernetesのセルフマネージドを選択してください。
- 迅速な対応が必要な場合、または分散データベースの運用上のオーバーヘッドがチームの作業効率を低下させる場合は、SingleStore Heliosを選択してください。
より大きな視点
Kubernetes上でデータベース(分散データベースやその他のステートフルワークロードを含む)を実行することは、もはや実験的な段階ではなく、標準的なものになりつつあります。
導入の成否を分けるのは、導入能力そのものではなく、長期にわたって安定的に運用できる能力です。
成功しているチームを見ると、それは本番稼働への準備をプロセスとして捉えているチームです。つまり、稼働開始前に検証を行い、初日から監視し、障害が発生する前に障害の挙動を把握しておくのです。
Kubernetes上のSingleStoreは、アーキテクチャの基盤を提供します。綿密な計画と検証済みのプロセスと組み合わせることで、チームは分散型の分析ワークロードとトランザクションワークロードを自信を持って実行できるようになります。