SingleStore Analystを最初に利用した顧客の1社が、通常であればデータチームに問い合わせるような質問をSingleStore Analystに投げかけました。顧客がAnalystに質問したのはこれが2回目でしたが、分析結果が返ってきたとき、データ部門の責任者はこう言いました。
「同じ分析を私のチームで行うには、2週間かかったでしょう。」
新たに構築すべきパイプラインも、提出すべきチケットも、スケジュールすべきスプリントもありませんでした。SingleStore Analystは既に業務で使用されているデータにクエリを実行し、数分で分析結果を返しました。
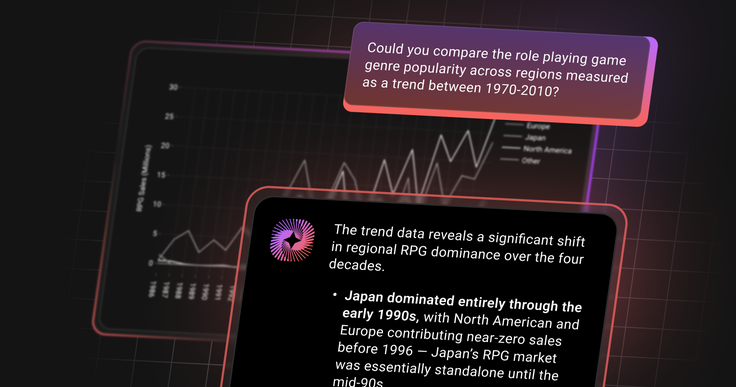
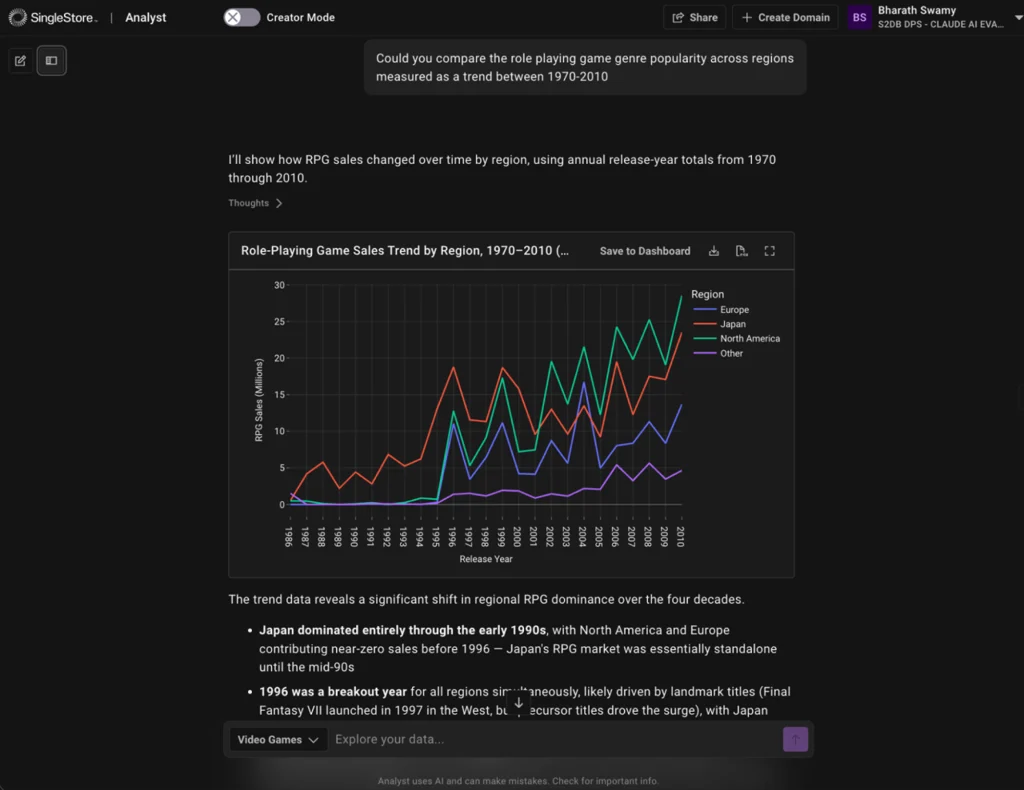
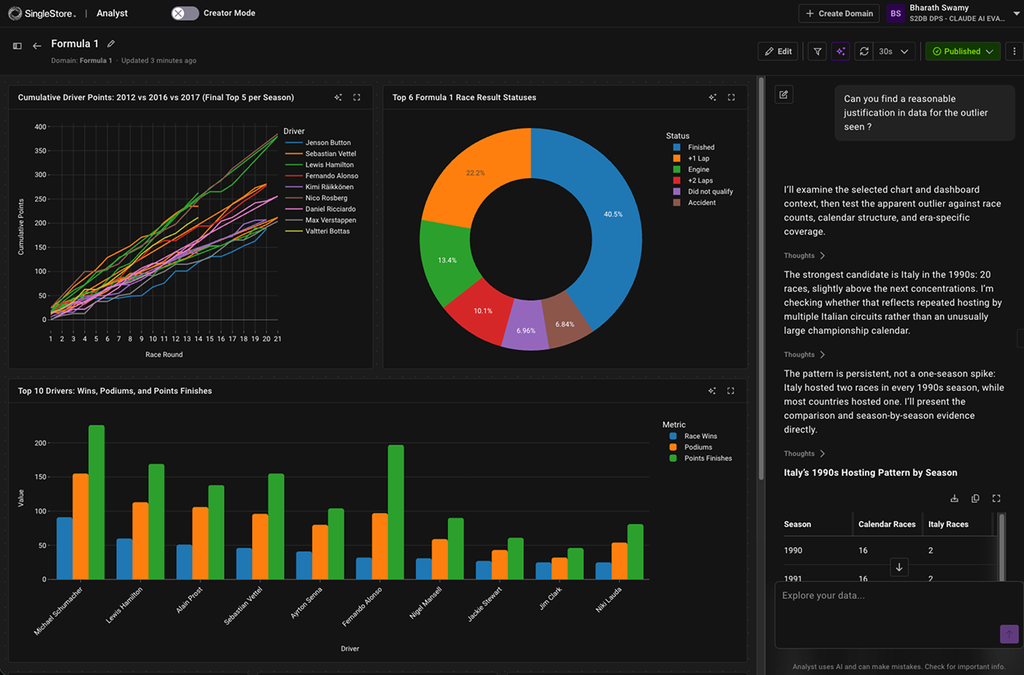
SingleStore Analystは、質問をSQLに変換して結果を視覚化するだけではありません。返されたデータを解釈し、データ全体の変化、変曲点、差異を特定し、それらを説明できる可能性のある追加の質問を提案します。それぞれの回答は、クエリの終了ではなく、調査の始まりとなるのです。
SingleStore Analystを稼働させる2つの方法
SingleStoreは、ワークロードが単一目的のエンジンでは対応しきれなくなった場合に、お客様が利用する分散型SQLデータベースです。同一行へのリアルタイム書き込みと大量読み取り、1つの実行パスでの複数データ型の処理、そして後付けではなくプラットフォームにネイティブに組み込まれた読み取りスケーリング機能を提供します。
チームはAnalystが使用できるテーブルを選択し、それらを解釈するために必要なビジネスコンテキストを追加します。ユーザーは平易な言葉で質問することができ、AnalystはSQLを処理し、結果を分析して回答を提示します。
既にSingleStoreで運用データを管理しているお客様にとっては、質問から回答までが直接的に解決できる道が開かれます。追加のシステムを導入する必要も、データを移動する必要も、同期を維持するための2つ目のコピーを作成する必要もありません。
Analystは、Postgres、MySQL、Oracle、SQL Server、またはMongoDBから複製されたデータに対しても実行できます。プレーン言語によるアクセスにより、データセットを照会できるユーザー数が増加し、エージェントは1つの質問に答える間に複数のクエリを発行できるため、同時実行性が急速に向上する可能性があります。Kafka、SingleStore Flow、または既存のCDCツールを使用して関連データをSingleStoreに複製すると、SingleStoreがクエリ負荷を吸収し、元のデータベースは記録システムとして残ります。
ライブインテリジェンスは、次の3つの条件が満たされている必要がある
企業データにAIエージェントを導入しようとしたことのある人に聞いてみれば、毎回同じ3つの要件が出てくると答えるでしょう。
コンテキストによって、それぞれの回答が適切なデータに基づいており、定義、関係性、権限はそのまま維持されること。
- 同時実行機能により、数千ものユーザー、アプリケーション、エージェントが互いに順番待ちすることなく、同時にクエリを実行できること。
- リアルタイムアクセスとは、回答が昨夜エクスポートされたコピーではなく、現在のデータに基づいていることを意味すること。
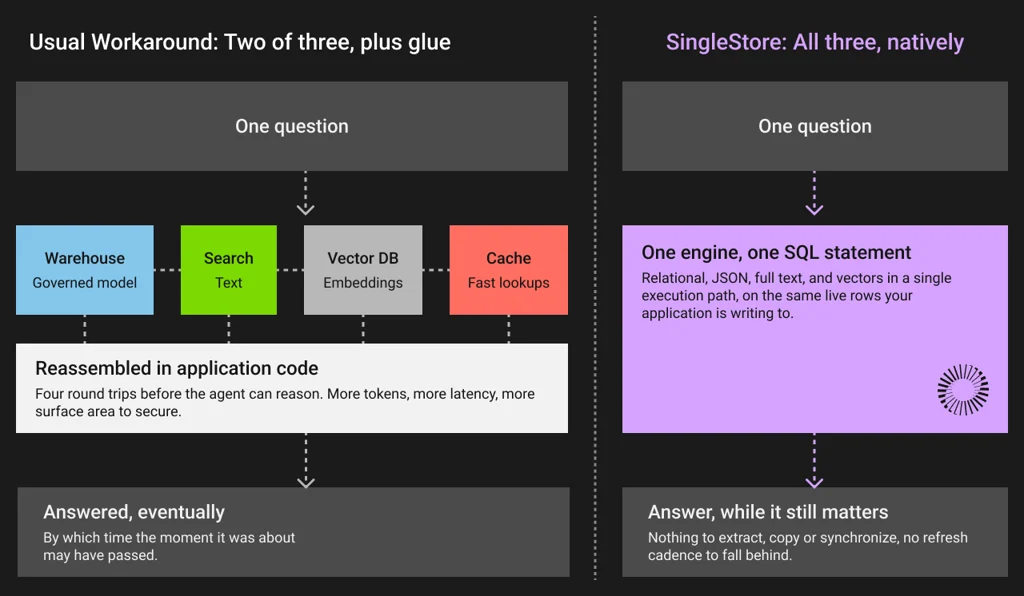
ほとんどのアーキテクチャは、3つのうち2つを実現できます。3つすべてを実現するには、通常、統制されたデータシステムに加え、低遅延クエリとベクトル検索のための独立したインフラストラクチャが必要です。パイプラインはこれらのシステムを同期させ続けなければならず、アプリケーションはコピーの調整とそれら全体にわたるアクセス制御の作業を継承します。チームはこれを実現できますが、複雑さがなくなったわけではなく、データベースからアプリケーションへと移行しただけです。
SingleStoreは、設計上、これら3つの機能をすべて1つのエンジンで実現します。Analystは、SingleStoreデータベース上で直接実行され、質問が行われている間、アプリケーションが書き込みを行っているのと同じ行にアクセスします。トランザクション書き込みと分析読み取りは同じデータにアクセスするため、抽出、コピー、同期を行う必要はなく、更新のタイミングが遅れることもありません。
人々が仕事中に尋ねる質問こそ、この点が最も重要になる場面であり、数分前の情報と最新の情報の違いが、答えの全てを左右するのです。
- 過去10分間に入金された支払いにおける不正利用率はどのくらいですか?
- 午前9時に開始したプロモーションは、実際にどれくらいの成果を上げているのでしょうか?
- 次の観光客の波が来る前に、この部屋、このルート、この商品(SKU)の価格を見直すべきでしょうか?
ほとんどのデータベースは、数分から数時間前のデータに対して、これらの質問に対する何らかの回答を提供できます。Kafkaパイプラインを使用して別の分析ストアにデータを転送することで、さらに最新のデータに近づけることも可能ですが、両方のデータベースを稼働させる必要があります。SingleStoreは、アプリケーションが現在も書き込みを行っている行と同じデータに対して、ミリ秒から数秒前の回答を提供します。そして、古い回答が古いことを知らされずに受け取った場合、ユーザーはツールへの信頼を失います。通常は静かに、そしてほとんどの場合、永久に。
私たちがAnalystを構築した方法は、お客様がSingleStore上でエージェントを構築する際の方法と同じです。会話の記憶、テーブルと列の意味に関する知識、埋め込み、ダッシュボードはすべてSingleStoreに格納されています。
ドメインは優れた回答の基盤となる
ドメインとは、独自の所有者、ユーザー、コンテキストを持つ、厳選されたデータベースとテーブルの集合です。ドメインは、スコープの単位であり、ガバナンスの単位であり、コンテキストの単位でもあります。Analystと話をする前に、アクティブなドメインを設定する必要があります。これは意図的な選択です。スコープのない質問には、Analystは自信を持って答えることができないからです。
1つのデータセットで、財務、マーケティング、経営陣といった個別のドメインをサポートできます。各ドメインには独自の所有者、ユーザー、ビジネスコンテキスト、権限が設定されているため、各グループは承認されたデータのみを閲覧できます。これは、汎用AIアシスタントを単一の認証情報でデータベースに接続する場合とは異なります。汎用AIアシスタントの場合、接続したすべてのユーザーに同じデータ範囲が付与されてしまう可能性があります。
ドメインを作成する際、Analystは多くの面倒な作業を自動で行ってくれます。Analystは、作成者が既にアクセスできるデータから開始し、選択したテーブルを自動的にインデックス化し、基となるテーブルデータをサンプリングして、各テーブルと列の意味を示す最初のドラフトを作成します。また、承認したテーブルのみに対して読み取り権限のみを持つ、そのドメイン専用のデータベースユーザーを作成します。ドメインからテーブルを削除すると、付与された権限は取り消されます。ドメインを削除すると、ユーザーも一緒に削除されます。
システムには、Analystが生成する予期せぬクエリが、稼働中のワークロードを支えるリソースを消費しないようにするための十分な安全対策が組み込まれています。レコーディング機能をオンにすると、すべての質問、すべての評価、そしてすべての回答の背後にあるSQLが管理者によって確認できるようになります。
ドメインは変化するものです。データやビジネスが変化するにつれて、所有者は範囲、意味、関係性を継続的に見直し、それに伴う答えも変化していきます。
コンテキストエンジンは回答の信頼性を高める
一般的に、あらゆるエージェントシステムの精度は、コンテキスト(文脈)の問題であることが多いです。精度は、誰かが手作業で維持する意味論的レイヤーに依存します。質問が手作業でキュレーションされた範囲から外れると、品質が低下します。高価な評価システムと、それを最新の状態に保つための専任チームがなければ、その低下に気づくことさえ非常に難しく、ましてや診断することは不可能です。
業界の多くのチームは、データベースに隣接して専用の複雑なシステムを構築することでこの問題に取り組んでいます。私たちのソリューションはContext Engineです。Context Engineはドメインの横ではなく、ドメイン内部に存在します。データのマッピング、ビジネス定義の学習、権限の適用、会話履歴の保持を行うことで、お客様のビジネスにおける現状に基づいた回答を提供します。Context Engineは一度構築すれば、そのドメイン内のすべてのインタラクションで共有されます。Context Engineはいくつかの異なるコンポーネントで構成されています。
ビジネスルールとは、企業固有の用語の意味を明文化したものです。収益に含まれる項目、含まれない勘定科目、会計年度の開始日、チーム内で実際に使われている用語などが含まれます。Analystはこれに基づいて回答するため、質問ごとに定義を改めて議論する必要がなくなり、あらゆる会話で一貫した定義が維持されます。
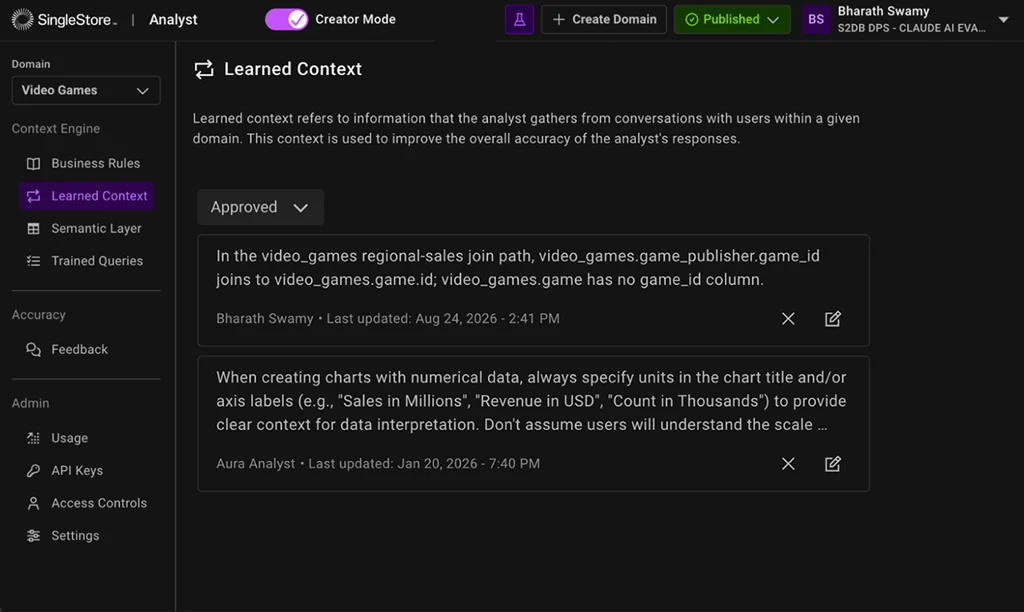
- 学習されたコンテキストとは、Analystが実際の質問から得た情報です。Analystはそれをドメイン管理者に提案し、承認、却下、または編集を求めます。学習した情報は自動的に公開されることはなく、それが重要な点です。コンテキストは、使用されるにつれて劣化するのではなく、蓄積されていきます。
- セマンティックレイヤーは、データ自体の生きたマップです。どのテーブルがスコープに含まれるか、列の意味、エンティティがどのように結合されるかなどを定義します。Analystはドメイン作成時にこのマップを作成し、チームはそこから継続的に改良を加えていきます。Analystが推論する結合は、暗黙のうちに想定されるのではなく、信頼度スコアとレビューキューとともに提供されます。推論された結合は誤る可能性があるため、これは想像以上に重要な点です。
- トレーニング済みクエリとは、Analystが参照パターンとして扱うべき、信頼できる質問とSQLのペアのことです。これによって、誤りが許されないメトリクスの背後にある正確なロジックを特定できます。
お客様が一切管理する必要のないレイヤーがもう1つあります。お客様のコンテキストに加えて、SingleStoreエンジン上で正しく動作し、高いパフォーマンスを発揮するSQLの書き方、高速なパターンやイディオム、そして当社独自のSQL方言の機能に関するグローバルな情報を保持しています。Analystが作成するすべてのクエリは、これら両方の情報に基づいて作成されます。その結果、ビジネス要件とエンジン要件の両方を考慮したクエリが生成されます。これは、エージェントとエンジンが同じ場所から提供される場合にのみ得られるメリットです。
すべてのコンテキストはバージョン管理されています。下書きを編集し、先週間違っていた問題と照らし合わせてテストし、公開済みのものと比較し、正しいものが公開されたら公開します。本番環境で実験を行う人はいません。
この分業体制こそ、実際に機能している例です。データに精通した人々がその意味を整理し、関係性を確認し、他のメンバーは質問をするだけです。専門知識は、実際にそれを持つ人々によって一度収集され、その後、組織全体で活用されるのです。
最高の洞察は舞台に立つに値する
チャットインターフェースは、学習や探索中に質問に答えるのに非常に優れています。しかし、ほとんどのビジネスでは、それ以上のものが必要です。例えば、今後2年間にわたって毎週月曜日の朝に「全く同じ質問」に対する答えを得ることであり、BIダッシュボードはまさにそのために作られたものです。
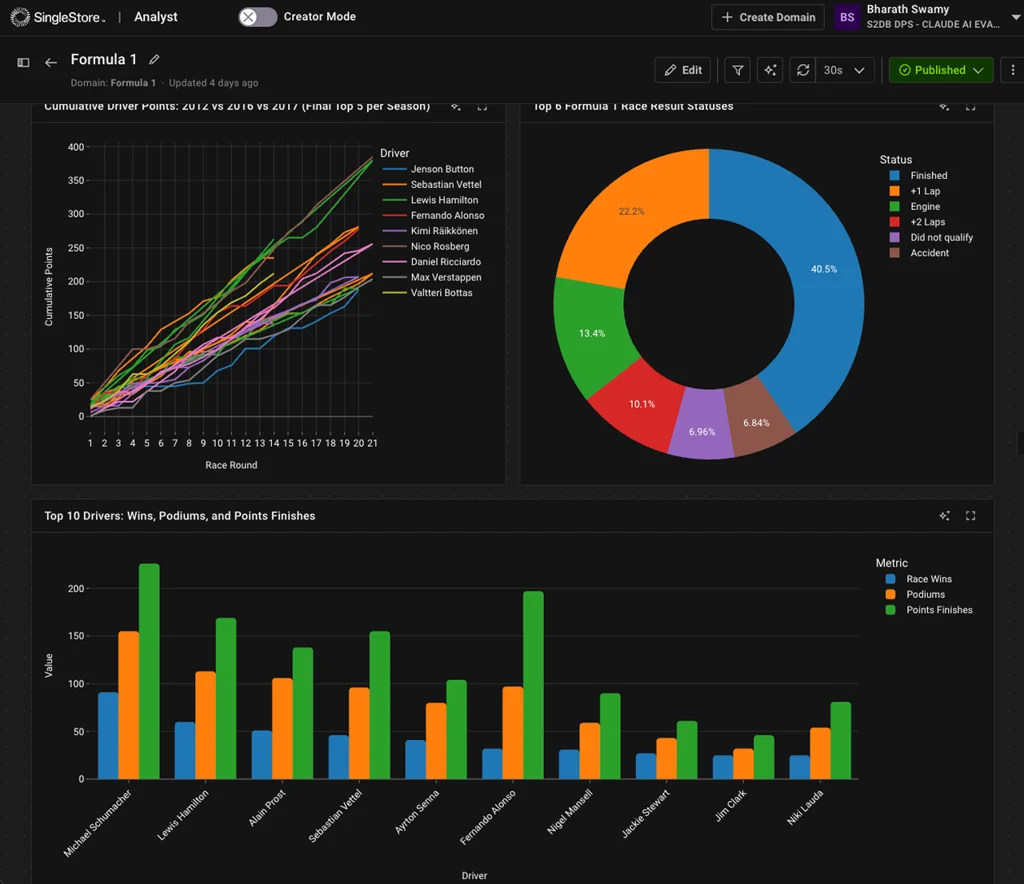
つまり、Analystが保存する価値のあるビジュアライゼーションを作成したら、それをダッシュ
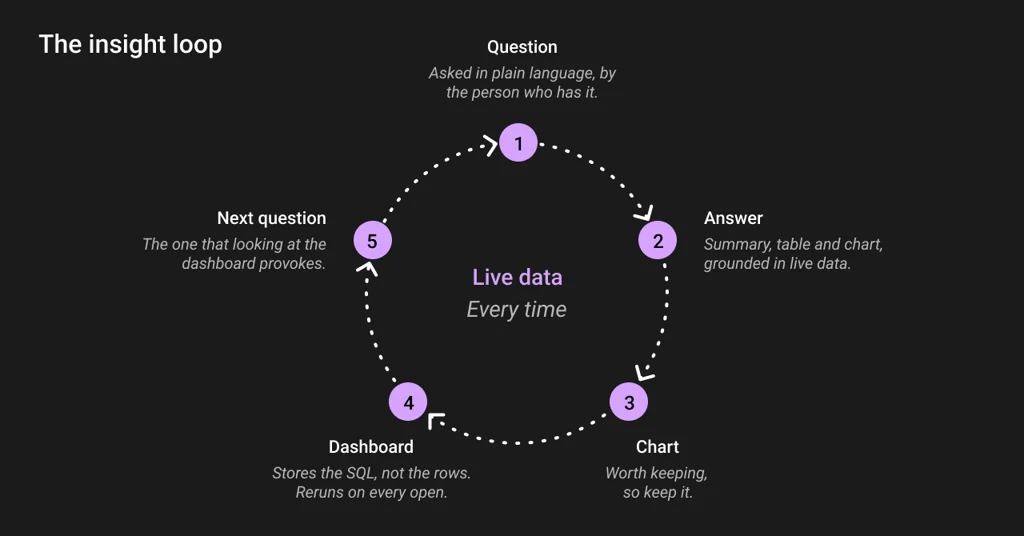
そのループこそが、SingleStoreの初期のお客様が繰り返し利用する部分であり、リアルタイムエンジンが単なるアーキテクチャ図上の概念としてではなく、経営幹部が実際に目で見て理解できる具体的なものへと変化する部分なのです。
ダッシュボードは、それが作成されたドメインのアクセスルールを継承するため、維持すべき2つ目の権限モデルは存在せず、アクセス権限のないデータに基づいて作成されたグラフをユーザーに渡すような事態も発生しません。
私たちが最初に構築したもの、そして次に構築するもの
このリリースは、ビジネスに関する疑問はあるもののSQLを記述できないユーザー向けに設計されています。ユーザーは対話形式でデータを探索し、インタラクティブなグラフで結果を確認し、便利なビューを最新の状態に保つダッシュボードに保存できます。データ専門家は、回答の質を左右する定義、関係性、クエリパターンを管理できます。
次に、アプリケーションへの組み込み分析をサポートすることで、ユーザー層を拡大します。統制されたリアルタイムインテリジェンスは、誰もが既に利用しているインターフェースで利用できるべきであり、お客様が自社ユーザー向けに構築するアプリケーション内でも利用できるべきです。Analystは、ユーザーがわざわざ離れてアクセスする必要のある場所ではなく、製品に組み込むことができるものになります。1つのシステムから多くの顧客にサービスを提供するということは、顧客間の真の分離を必要としますが、この分離はエンジンに組み込まれており、後付けで追加されるものではありません。
準備が整い次第、詳細をお知らせします。今のところは、Analystにデータを指定し、読み取りを許可するテーブルを選択して、現在発生している事象について質問してみてください。