SingleStore Universal Storageは、分析ワークロードとトランザクションワークロードの両方をサポートできる単一のテーブルです。長年にわたり、分析ワークロードとトランザクションワークロードにはそれぞれ専用のデータベースとテクノロジーが必要だと多くの人が考えていました。SingleStoreは、その考えが誤りであることを証明しました。7.5リリースでは、Universal Storageテクノロジーの第4弾として、複数列キーのサポートと、新規インストール時のデフォルトのテーブルタイプとして列ストアを追加しました。Universal Storageの主要な機能はすべて完成したことを誇りに思います。
これは、SingleStore独自の特許取得済みUniversal Storage機能について説明する4部構成の記事の最終回です。全容をご理解いただくには、パート1、パート2、パート3をお読みください。
Universal Storageの主な利点は次のとおりです。
(1) 総所有コスト(TCO)の削減。UPSERTやユニークキーの強制を必要とする一般的な操作では、データ全体をRAMに収める必要がないためです。これにより、高額になりがちな大容量のRAMを搭載したサーバーが不要になり、コスト削減につながります。
(2) 複雑さが軽減されます。行ストアで操作を実行してからデータを列ストアに移動する必要がなくなり、これまで不可能だった速度とパフォーマンスが実現します。
(3) UPSERT、一意キーの適用、高速ルックアップ、その他のOLTPスタイルの操作と組み合わせることで、大規模テーブルでの分析パフォーマンスが向上します 。これは、列ストアテーブルでは分析クエリが1コアで毎秒数億行を処理できるのに対し、行ストアではコアあたりのピークパフォーマンスが毎秒約2,000万行であるためです。
Universal Storage 7.5 の新機能
7.0、7.1、7.3リリースでは、OLTPスタイルのストレージ構造でのみ可能とされていた機能を実現するために、列ストアテーブル型を進化させました。具体的には以下の機能が含まれます。
- サブセグメント アクセス (位置がわかっている場合に 1 つまたは少数のレコードを取得するための列ストア* への高速シーク)
- 単一列ハッシュインデックス
- 単一列の一意のインデックス、制約、および主キー
- UPSERTサポート
- 列ストアをデフォルトのテーブルタイプとして設定するオプション
*この新しい列ストアテーブルタイプは、Universal Storageと呼ばれています。ただし、構文では引き続き「columnstore」と呼ばれます。
7.5 では以下がサポートされるようになりました:
- 複数列ハッシュインデックス
- 複数列の一意性
- 複数列の一意のキーを持つテーブルへのUPSERT
- 新しいクラスターのデフォルトのテーブルタイプとして列ストアをデフォルトで使用
機能面では、Universal Storageはこれで完成です。今後、表面積を増やす予定はありません。パフォーマンスは優れていますが、さらに向上させる余地がありますので、今後のリリースでの進捗にご期待ください。
例
この記事で取り上げる例は次のとおりです。
- TPC-Hの行項目テーブルに2,800万行のデータをロードする
- そのデータを、2つの列を持つ一意のキーを持つテーブルに移動する
- この一意のキーが強制されていることを示す
- このユニークなキーを検索して、それがどれだけ速いかを示します
lineitem テーブルは現実的なテーブルであり、トランザクション、分析、またはその両方を実行する eコマースアプリケーションをサポートするために使用されるテーブルに似ています。一意性の強制は、あらゆる種類のアプリケーションに共通する要件です。データベースが自動的に一意性を強制することは、データの整合性を自動的に保証し、アプリケーション開発者がアプリケーションコードで一意性を強制する必要がなくなるため、当然ながらメリットがあります。
明細項目テーブルへの読み込み
SingleStore StudioとS2MS管理コンソールはどちらも、TPC-Hデータセットをスケールファクター100で簡単にロードできます。ここでは、データの一部だけをロードし、明細項目データが約2,800万行に達した時点でロードを停止することで、開始時間を短縮しています。実際には、StudioからTPC-Hデータをロードする例の一部をコピーしただけです。
このテストを自分で繰り返すには、次のコマンドを実行します。
1DROP DATABASE IF EXISTS tpch;2CREATE DATABASE tpch;3USE tpch;4
5CREATE TABLE `lineitem` (6   `l_orderkey` bigint(11) NOT NULL,7   `l_partkey` int(11) NOT NULL,8   `l_suppkey` int(11) NOT NULL,9   `l_linenumber` int(11) NOT NULL,10   `l_quantity` decimal(15,2) NOT NULL,11   `l_extendedprice` decimal(15,2) NOT NULL,12   `l_discount` decimal(15,2) NOT NULL,13   `l_tax` decimal(15,2) NOT NULL,14   `l_returnflag` char(1) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,15   `l_linestatus` char(1) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,16   `l_shipdate` date NOT NULL,17   `l_commitdate` date NOT NULL,18   `l_receiptdate` date NOT NULL,19   `l_shipinstruct` char(25) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,20   `l_shipmode` char(10) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,21   `l_comment` varchar(44) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,22   SHARD KEY (`l_orderkey`) USING CLUSTERED COLUMNSTORE23);24
25CREATE OR REPLACE PIPELINE tpch_100_lineitem26AS LOAD DATA S3 'memsql-tpch-dataset/sf_100/lineitem/'27config '{"region":"us-east-1"} '28SKIP DUPLICATE KEY ERRORS29INTO TABLE lineitem30FIELDS TERMINATED BY '|'31LINES TERMINATED BY '|\n';32
33START ALL PIPELINES;
ここで、別のセッションでこのクエリを実行して、パイプラインの進行状況を確認できます。
1SELECT2 CONCAT(PIPELINE_NAME) AS pipelineId,3 sub.BATCH_STATE AS lastBatchState,4 IFNULL(sub.BATCH_ROWS_WRITTEN, 0) AS lastBatchRowsWritten5 FROM (6 SELECT7 DATABASE_NAME,8 PIPELINE_NAME,9 BATCH_STATE,10 BATCH_ROWS_WRITTEN,11 ROW_NUMBER() OVER (12 PARTITION BY DATABASE_NAME,13 PIPELINE_NAME14 ) AS r15 FROM16 INFORMATION_SCHEMA.PIPELINES_BATCHES_METADATA17 WHERE18 BATCH_STATE NOT IN ('No Data', 'In Progress')19 ) sub20 WHERE21 r = 1 AND DATABASE_NAME='tpch'22 ORDER BY pipelineId ASC;
十分なデータ(約 2,800 万行)がロードされたら、パイプラインを停止して、時間がかかりすぎないようにし、スペースをあまり使用しないようにすることができます(使用可能な行は合計で約 6 億行あります)。
1stop all pipelines;
次にテーブルのサイズを確認します。
1select format(count(*), 0) from lineitem;
2列の一意のキーを持つlineitem_ukテーブルを作成する
ここで、主キーを持つ別のバージョンのテーブルを作成します。
1set global default_table_type = 'columnstore';2
3create table `lineitem_uk` (4   `l_orderkey` bigint(11) NOT NULL,5   `l_partkey` int(11) NOT NULL,6   `l_suppkey` int(11) NOT NULL,7   `l_linenumber` int(11) NOT NULL,8   `l_quantity` decimal(15,2) NOT NULL,9   `l_extendedprice` decimal(15,2) NOT NULL,10   `l_discount` decimal(15,2) NOT NULL,11   `l_tax` decimal(15,2) NOT NULL,12   `l_returnflag` char(1) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,13   `l_linestatus` char(1) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,14   `l_shipdate` date NOT NULL,15   `l_commitdate` date NOT NULL,16   `l_receiptdate` date NOT NULL,17   `l_shipinstruct` char(25) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,18   `l_shipmode` char(10) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,19   `l_comment` varchar(44) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,20   shard key (l_orderkey),21   sort key(l_shipdate),22   primary key(l_orderkey, l_linenumber)23);
次に、これを実行してデータを lineitem_uk に移動します。
1insert into lineitem_uk2select * from lineitem;
一意性が強制されていることを検証します。
まず、一意性が本当に確保されているか確認しましょう。以下を実行します。
1insert into lineitem_uk2select * from lineitem limit 1;
次のエラーが表示されます: ERROR 1062 ER_DUP_ENTRY: Leaf Error (172.17.0.2:3308): Duplicate entry '19805284-1' for key 'PRIMARY'
すでにその行を lineitem_uk に入力したことがわかっているので、これは予想どおりの結果です。
複数列のユニークキー検索のパフォーマンスのプロファイリング
それでは、キーを使って1行を検索するシーククエリのプロファイルを作成しましょう(読み込みを途中で停止した場合は、l_orderkey = 364000000 の行が存在するかどうかを確認する必要があるかもしれません。存在しない場合は、存在する別の l_orderkey 値を選択し、その値を使用するように以下のクエリを修正してください)。すべての注文の l_linenumber は 1 なので、これは常に安全な選択です。では、単一行のルックアップを実行してみましょう。
1select * from lineitem_uk2where l_orderkey = 364000000 and l_linenumber = 1;
私の場合、ColumnStoreScan演算子(実際には(l_orderkey, l_linenumber)の主キーインデックスを使ってシークを行う)のプロファイルに約2ミリ秒かかりました。8コアの新しいMacBookを使用しています。Studioでプロファイルを作成するには、SQLペインの右上にある「…」をクリックし、プロファイルオプションを選択します。ColumnStoreScan演算子にマウスオーバーすると、所要時間が表示されます。正確な結果を得るには、2回実行する必要があります。
このテーブルのように中程度の幅を持つ列ストアテーブルへのシーク時間は2ミリ秒で、予想通り非常に高速です(以前のUniversal Storageブログで紹介しました)。これは列ストアにおけるOLTPレベルの速度です。
複数列キー列ストアでのアップサート
これまでお客様がSingleStoreにデータを取り込む際に最も多く遭遇した問題の一つは、ストリーミングUPSERTワークロードがあり、それを実行するにはまずデータを行ストアにロードする必要があったことです。その後、データが安定した後(例えば数日後)、長期保存のために列ストアに移行していました。行ストアはRAMに格納する必要があるため、RAMのコストを節約するためです。列ストアと行ストアからデータを取得して結合するには、クエリを変更する必要がありました。これは開発者にとって余分な作業でした。
こうしたワークロードにおける多くのUPSERT操作は、複数列の一意キーに依存しています。SingleStore 7.5までは、複数列の一意キーがある場合、Universal Storage(列ストア)へのUPSERTを直接実行することはできませんでした。しかし、SingleStore 7.5では、複数列のUPSERTワークロードを列ストアテーブルに直接実行できるようになりました。つまり、行ストアから列ストアにデータを移行したり、「ホット」行ストアと「長期アーカイブ」列ストアという2つのテーブルからデータを複雑に組み合わせたりする必要がなくなりました。
以下の例を理解するために、SingleStore でサポートされているUPSERTスタイルの操作に関する優れたリファレンスがここにあります。
最も基本的な条件付き挿入は、実際にはUPSERTではなく、INSERT IGNOREです。例として、次のように作成された2行のステージングテーブルがあるとします。
1create table upsert_records as select * from lineitem_uk limit 2;
これを実行すると、次のキーを持つレコードが取得されました。
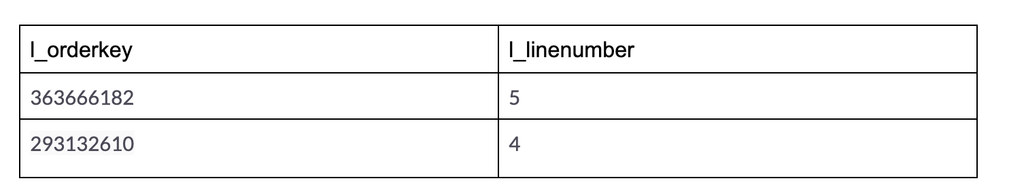
事前に、419382341 という l_orderkey は最大値より1つ大きいため、lineitem_ukには存在しないことを確認しておきました。
そこで、upsert_records の 1 つをこの値に変更して、新しい一意のキーを持つようにします。
1update upsert_records set l_orderkey = 4193823412where l_orderkey = 293132610 and l_linenumber = 4;
ここで、この INSERT IGNORE を実行すると、新しいキーを持つレコードは 1 つだけなので、2 つではなく 1 つの新しいレコードが取得されることがわかります。
1insert ignore into lineitem_uk2select * from upsert_records;
ここで、実際の upsert のために、upsert_records の 1 つの l_quantity を変更してみましょう。
1update upsert_records set l_quantity = 500.002where l_orderkey = 363666182 and l_linenumber = 5;
この INSERT ON DUPLICATE KEY UPDATE ステートメントは、重複キーを検出すると、l_quantity を更新します。
1insert into lineitem_uk (2 `l_orderkey`,3 `l_partkey`,4 `l_suppkey`,5 `l_linenumber`,6 `l_quantity`,7 `l_extendedprice`,8 `l_discount`,9 `l_tax`,10 `l_returnflag`,11 `l_linestatus`,12 `l_shipdate`,13 `l_commitdate`,14 `l_receiptdate`,15 `l_shipinstruct`,16 `l_shipmode`,17 `l_comment`18 )19select * from upsert_records20on duplicate key update21l_quantity = values(l_quantity);
これにより、lineitem_uk レコードの 1 つに対する l_quantity が更新されたことが示されます。
1select s.*2from lineitem_uk s, upsert_records r3where s.l_orderkey = r.l_orderkey4and s.l_linenumber = r.l_linenumber;
列ストアに必要な複数列の一意キーがある場合、その他のすべてのupsert形式のコマンドと操作も列ストアターゲットで使用できるようになりました。これには、REPLACE、およびパイプラインとLOAD DATAのREPLACE、IGNORE、SKIP DUPLICATE KEY、ON DUPLICATE KEY UPDATEオプションが含まれます(該当する場合)。
Universal Storageの未来
Universal Storage の主要な機能はすべて実装済みです。ほとんどのアプリケーションは 7.5 でそのまま使用でき、高速シーク、一意性の強制、高速アップサート、高速分析といったメリットを享受できます。今後さらに改善していく予定です。例えば、インメモリ列ストアバッファキャッシュを導入することで、シーク時間をさらに短縮できる可能性があります。現在は、ファイルシステムのバッファキャッシュを利用して、最近アクセスした列ストアデータを RAM にキャッシュしています。これは驚くほどうまく機能していますが、独自のバッファキャッシュを持つことで、クエリ実行中にデータをコピーする際の CPU コストを削減できる可能性があります。
さらに、将来のリリースでは列ストアに対するSELECT FOR UPDATEのサポートを追加する予定です。現時点では行ストアでは動作しますが、列ストアでは動作しません。SELECT FOR UPDATEは、特定のOLTPスタイルの更新に対してシリアル化可能な分離性が必要な場合に便利です。
まとめ
Universal Storageエピソード4では、マルチカラムキーとUPSERTの完全サポートを追加し、列ストアをデフォルトのテーブルタイプとすることで、Universal Storageの物語に終止符を打ちます。これは、列ストアという単一のテーブルタイプでほぼすべての処理を実行できるようにすることで、TCOの削減とアプリケーション開発の簡素化に向けた大きな前進です。
Universal Storageを使用すると、行ストアを最高のパフォーマンスが求められるOLTPスタイルの操作に予約できます。列ストアでは、小規模な挿入、削除、更新を行うSQL文、高速シーク、小規模から大規模までの集計など、必要な処理のほぼすべてを実行できます。
Singlestore Helios トライアルまたは SingleStoreDB Self-Managed 無料エディションを使用して、SingleStore を無料でお試しください。
SingleStore の特許取得済みUniversal Storage機能の全容を知るには、シリーズのパート 1、パート 2、パート 3をお読みください。